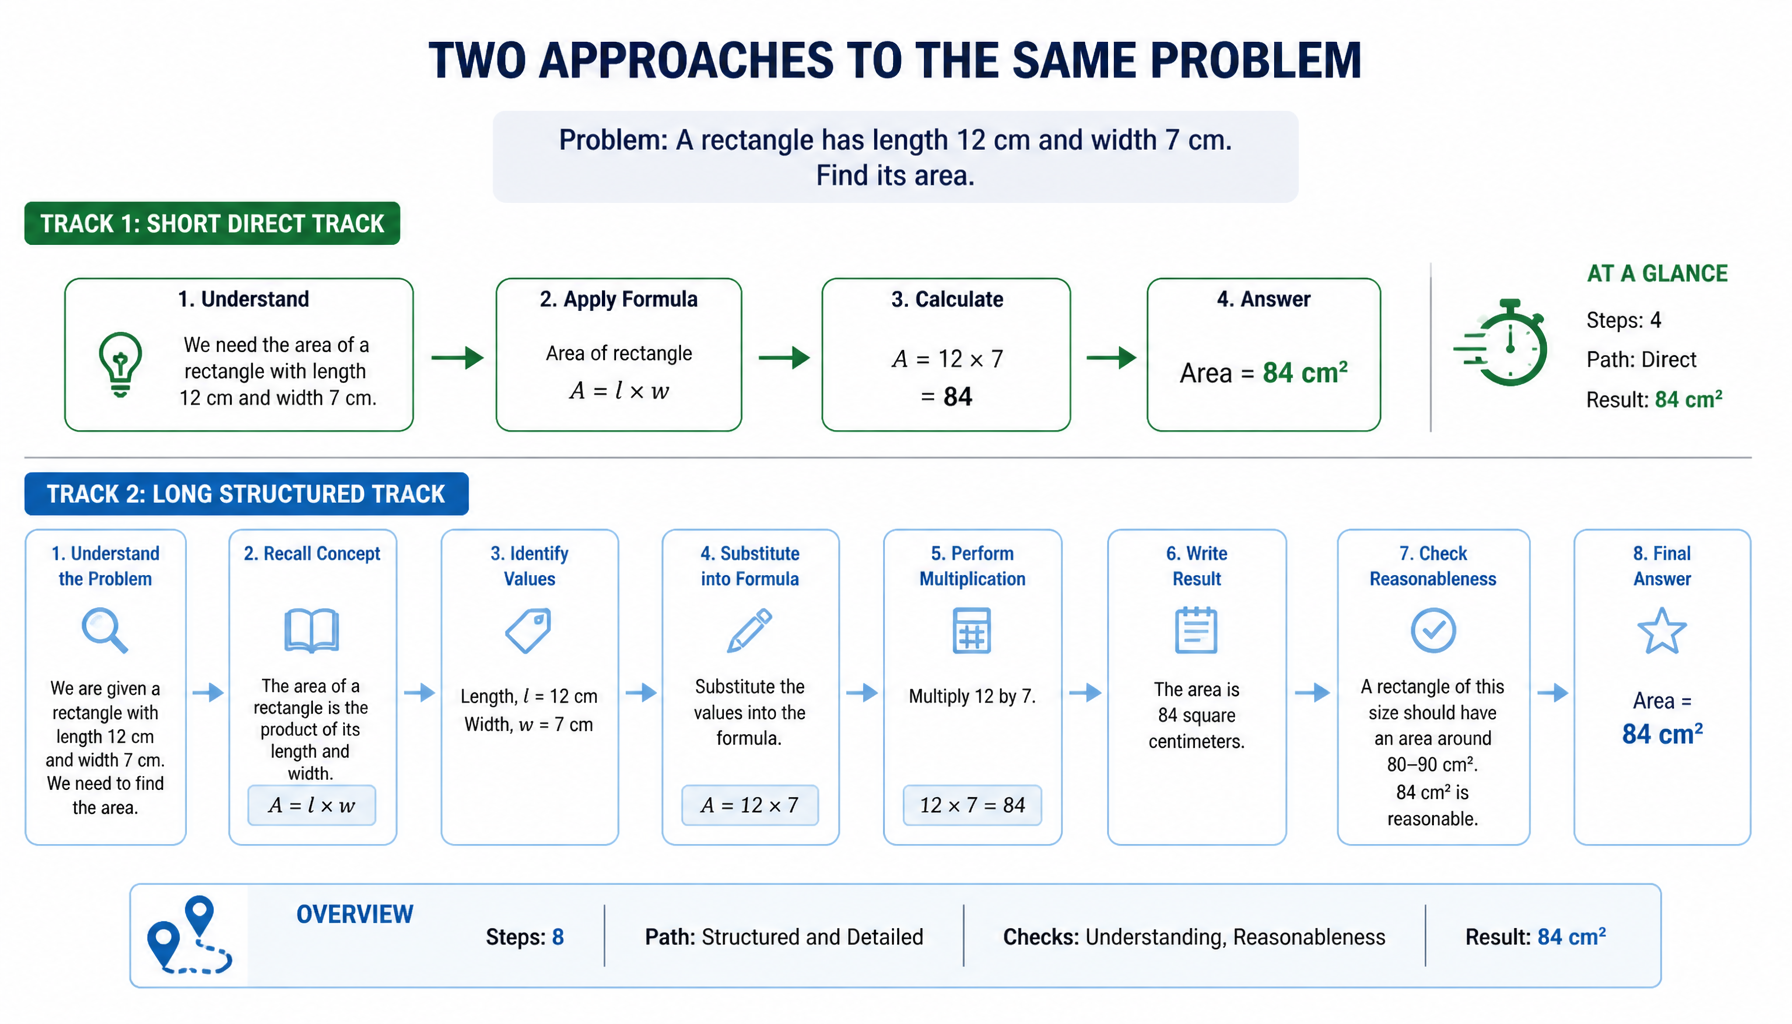
تصور کنید یک مسئله ریاضی بسیار سخت و پیچیده را جلوی یک دانشآموز تیزهوش میگذارید و از او میخواهید بلافاصله و در کسری از ثانیه بدون هیچ درنگ یا نوشتن راهحل روی تخته، پاسخ نهایی را به زبان بیاورد. احتمال خطای او حتی با وجود هوش بسیار بالا چقدر است؟ بسیار زیاد! حال تصور کنید به او اجازه میدهید ابتدا مراحل فرمولها را روی تخته بنویسد، مقادیر میانی را حساب کند و پلهپله جلو برود. قطعاً درصد موفقیت او به شدت افزایش خواهد یافت. پدیده شگفتانگیز این است که مدلهای زبانی بزرگ (LLM) نیز در زمان استنتاج، رفتاری کاملاً مشابه دارند.
تکنیک زنجیره اندیشه (Chain-of-Thought - CoT) یکی از انقلابیترین کشفها در حوزه تعامل با هوش مصنوعی است. این تکنیک به مدل اجازه میدهد تا قبل از خروجی نهایی، یک مسیر استدلال متنی برای خود ترسیم کند و از توکنهای تولید شده به عنوان حافظه موقت محاسباتی بهره ببرد. در این جستار تخصصی و عمیق، قصد داریم ریاضیات، مفاهیم و تکنیکهای مهار CoT را به روشی غیرتکراری کالبدشکافی کنیم. اگر به مفاهیم پایه پرامپتنویسی علاقهمند هستید، پیشنهاد میکنیم مقالات قبلی وبلاگ ما شامل مهندسی پرامپت از صفر تا صد: هنر گفتوگو با هوش مصنوعی و الگوهای طراحی کاربردی در ۱۰ الگوی پرامپتنویسی حرفهای که کیفیت خروجی شما را متحول میکند را مطالعه فرمایید. تسلط بر این روشها گامی کلیدی در ساخت برنامههای کاربردی پایدار و مبتنی بر هوش مصنوعی است.
داستانِ یک درنگ: چرا هوش مصنوعی به فضا و زمان برای فکر کردن نیاز دارد؟
مدلهای زبانی بزرگ از نوع خودبازگشت (Autoregressive) هستند. این یعنی مدل توکنها را تکبهتک و بر اساس احتمالات ریاضی توکنهای قبلی تولید میکند. اگر شما سوالی از یک مدل بپرسید که پاسخ آن نیازمند استدلال چندمرحلهای باشد و مستقیماً پاسخ نهایی را مطالبه کنید، مدل تلاش میکند در اولین گام، کلمه نهایی را پیشبینی کند. این کار مانند این است که بخواهید ضرب دو عدد پنج رقمی را در ذهن خود بدون انجام محاسبات واسط و به صورت کاملاً تصادفی حدس بزنید. زنجیره اندیشه با وادار کردن مدل به تولید گامهای میانی، به لایههای توجه ترنسفورمر اجازه میدهد در هر مرحله، بر روی جزئیات کوچکتر تمرکز کنند.
این فرآیند تولید توکنهای میانی، فضا و زمان مورد نیاز برای اجرای محاسبات عمیقتر را در اختیار شبکه عصبی قرار میدهد. در حقیقت ترنسفورمرها در هر مرحله تولید توکن جدید، مقدار مشخصی منابع پردازشی مصرف میکنند. با وادار کردن مدل به نوشتن مسیر تفکر، ما منابع محاسباتی را به صورت پویا افزایش میدهیم. برای مهار پایداری مدل در محاسبات طولانی، تنظیم پارامترهای دکودینگ (Decoding) که در مقاله دمای مدل (Temperature)، Top-P و Top-K: چطور خلاقیت و دقت خروجی LLM را کنترل کنیم؟ بررسی کردیم، اهمیت زیادی پیدا میکند؛ زیرا بالا بودن دما در طول زنجیرههای طولانی تفکر میتواند انحرافات منطقی مدل را افزایش دهد.
کالبدشناسی زنجیره اندیشه: پشت صحنه ریاضی چه میگذرد؟
در مدلهای زبانی خودبازگشت، توکن بعدی بر اساس تابع Softmax روی دایره واژگان مدل پیشبینی میشود. ریاضیات استنتاج استاندارد تلاش میکند احتمال خروجی نهایی y را به شرط ورودی x به صورت مستقیم محاسبه کند: P(y|x). در این حالت مدل هیچ مسیر محاسباتی میانی ندارد و تمام محاسبات سنگین استدلالی را باید در طول یک گام ترنسفورمری انجام دهد که این امر منجر به خطا میشود. اما در تکنیک Chain-of-Thought، ما یک متغیر پنهان به نام زنجیره استدلال z معرفی میکنیم که شامل گامهای واسط حل مسئله است. در این فرآیند، احتمال تولید خروجی به صورت زیر بازنویسی میشود:
P(y, z | x) = P(z | x) * P(y | x, z)
این فرمول ساده نشان میدهد که ابتدا مدل احتمال درستی زنجیره استدلال z را به شرط سوال x محاسبه میکند، و سپس پاسخ نهایی y را با تکیه بر هر دو عامل x و z به دست میآورد. از آنجا که z حاوی مراحل پلهپله حل مسئله است، شرطی شدن y بر روی z خطا را به طرز شگفتانگیزی کاهش میدهد. لایههای توجه مدل به جای جهش مستقیم، بر روی نتایج گامهای قبلی که در حافظه بافتار وجود دارند تمرکز کرده و توکن بعدی را با دقت بسیار بالاتری حدس میزنند. این یعنی بار محاسباتی در طول ابعاد زمان استنتاج توزیع میشود.
تولد یک پرامپت تاریخی: بررسی پرامپت جادویی «بیا مرحله به مرحله فکر کنیم»
در سال ۲۰۲۲، گروهی از محققان گوگل و دانشگاه توکیو در مقالهای با عنوان «مدلهای زبانی بزرگ، استدلالکنندههای بدون نمونه هستند» کشف شگفتانگیزی کردند. آنها متوجه شدند که با اضافه کردن عبارت ساده زیر به انتهای سوالات منطقی و ریاضی، نرخ موفقیت مدلها در حل مسائل سخت ریاضی (مثلا دیتاست MultiArith) از ۱۷.۷ درصد به ۷۸.۷ درصد افزایش مییابد:
"Let's think step by step"
این تکنیک که به عنوان Zero-Shot CoT شناخته میشود، بدون نیاز به ارائه هیچ مثالی، به صورت خودکار مدل را وارد فاز استدلال خطی و گامبهگام میکند. محققان بعدها متوجه شدند که مدل بیش از ۱۴ پرامپت استدلالی مختلف را تست کرده است (مانند بیا این مسئله را حل کنیم) اما این پرامپت خاص به دلیل همسویی بالا با دادههای آموزشی و کدهای تشریحی موجود در دادههای پیشتمرین، بهترین نتیجه را برای فعالسازی ویژگیهای استدلالی مخفی ترنسفورمرها به دست داده است. این یعنی پرامپتهای استدلالی مانند یک کاتالیزور برای مسیرهای توجه عمل میکنند.
شاخهای پیشرفته زنجیره تفکر
با پیشرفت این حوزه، تکنیکهای پیشرفتهتری بر پایه زنجیره اندیشه ابداع شدهاند:
- Few-Shot CoT: ارائه چند مثال نمونه به مدل که در آنها نه تنها پاسخ نهایی، بلکه کل مسیر حل مسئله نیز به صورت کاملاً تشریحی و خوانا نوشته شده است. این روش به مدل استایل و لحن دقیق تفکر ریاضی را القا میکند. نقطه ضعف آن، پر شدن پنجره ورودی با مثالهای تکراری و طولانی است؛ در حالی که روش Zero-Shot بسیار سبکتر بوده و کلید فعالسازی خودکار است.
- مکانیزم خودسازگاری (Self-Consistency): در این متد، مدل چندین مسیر تفکر متفاوت را با دمای بالاتری تولید میکند (مثلاً ۱۰ مسیر مجزا). سپس با شمارش پاسخهای نهایی به دست آمده از این مسیرها، متداولترین گزینه (اکثریت آرا) به عنوان پاسخ قطعی برگزیده میشود که این کار خطاهای مقطعی مدل را خنثی میسازد. این کار هزینه توکن را ۱۰ برابر میکند اما در پروژههای مالی و حیاتی کاملاً توجیهپذیر است. تلفیق خودسازگاری با زنجیره اندیشه نشان داده است که دقت در سوالات استدلالی چندمرحلهای تا ۱۵ درصد بیشتر از روش زنجیره اندیشه ساده افزایش مییابد.
- درخت اندیشه (Tree of Thoughts): مدل مسائل را به صورت یک درخت تصمیمگیری با چندین شاخه موازی حل میکند. در هر گام، یک ارزیابیکننده (Validator) کیفیت آن استدلال را با معیارهایی نظیر جستجوی اول سطح (BFS) یا اول عمق (DFS) میسنجد و در صورت لزوم مسیرهای اشتباه هرس شده و مدل به شاخه قبلی بازمیگردد. این ساختار امکان حل پازلهای دشوار منطقی را فراهم میکند. در واقع الگوریتم ToT با شبیهسازی جستجوی سیستماتیک، به عاملها کمک میکند تصمیمات استراتژیک بلندمدت را با ارزیابی دقیق شرایط اتخاذ کنند.
محدودیتها و مرزهای تفکر ترنسفورمری
با وجود کارایی بالا، زنجیره اندیشه دارای محدودیتها و هزینههای خاص خود است که معماران سیستم باید به آنها توجه کنند تا از هدررفت منابع جلوگیری شود:
- مصرف بالای توکن و هزینهها: از آنجا که مدل مجبور است حجم زیادی متن تفکری تولید کند، تعداد توکنهای خروجی به شدت افزایش مییابد که هزینه مالی استفاده از APIها را بالا برده و زمان پاسخدهی (Latency) را طولانی میکند. این امر برای وبسایتهای بلادرنگ چالشساز است و سرعت نهایی برنامه را کاهش میدهد.
- پدیده انباشت خطا (Cascade of Errors): اگر مدل در اولین یا دومین مرحله محاسباتی خود مرتکب یک اشتباه منطقی یا ریاضی کوچک شود، کل زنجیرههای بعدی بر روی این فرض غلط ساخته شده و پاسخ نهایی کاملاً اشتباه خواهد بود. مدل با اعتماد به نفس بالا مسیر غلط را توجیه میکند. برای مثال محاسباتی شبیه به ۲ ضربدر ۳ مساوی ۵، کل مراحل بعدی فیزیک پروژه را نابود خواهد کرد و مدل تا انتهای استدلال متوجه تناقض کارهای خود نخواهد شد.
یک قطعه کد پایتون برای خودکارسازی فرآیند چندمرحلهای تفکر و استخراج پاسخ
در سیستمهای توسعه نرمافزار، ما معمولاً نمیخواهیم چرکنویس یا تفکرات میانی مدل به کاربر نهایی نشان داده شود. کادر زیر یک کلاس پایتون را نشان میدهد که با پیادهسازی الگوی دو مرحلهای، ابتدا زنجیره اندیشه را فعال کرده و سپس پاسخ نهایی تمیز را بدون نشان دادن چرکنویس استخراج میکند. توجه داشته باشید که متغیرهای قالببندی با دوبل کردن آکاردئونها به درستی مدیریت شدهاند. این کد را میتوان به عنوان یک ابزار پایهای در خط لوله عاملهای هوشمند استفاده نمود:
import urllib.request
import json
class CoTPipeline:
def __init__(self, model_url="http://localhost:11434/api/generate"):
self.url = model_url
self.model = "llama3:8b-instruct-q4_K_M"
def _query(self, prompt):
payload = {
"model": self.model,
"prompt": prompt,
"stream": False
}
req = urllib.request.Request(
self.url,
data=json.dumps(payload).encode('utf-8'),
headers={"Content-Type": "application/json"},
method="POST"
)
try:
with urllib.request.urlopen(req) as response:
res = json.loads(response.read().decode('utf-8'))
return res.get("response")
except Exception as e:
return f"Error: {e}"
def run_reasoning_task(self, problem):
# گام اول: فعالسازی زنجیره اندیشه تشریحی
cot_prompt = f"Problem: {problem}\nExplain your step-by-step reasoning clearly before giving the answer."
thought_process = self._query(cot_prompt)
# گام دوم: استخراج پاسخ نهایی از دل تفکرات
extraction_prompt = f"Reasoning Steps:\n{thought_process}\nBased on the steps above, output ONLY the final clean answer, without any description."
final_answer = self._query(extraction_prompt)
return thought_process, final_answer
# نمونه استفاده از کلاس در برنامه
# pipeline = CoTPipeline()
# thoughts, answer = pipeline.run_reasoning_task("اگر ۵ سیب داشته باشم و ۲ تا را بخورم و ۳ تا بخرم، چند سیب دارم؟")
کلام پایانی: هنر آرام گرفتن و اندیشیدن
کلام نهایی این است که کشف زنجیره اندیشه به ما نشان داد که معماریهای کنونی هوش مصنوعی نیز برای حل مسائل سخت، نیاز به درنگ و تامل دارند. به عنوان توسعهدهنده نرمافزار، شناخت زمان و نحوه استفاده از CoT به شما اجازه میدهد تعادل مناسبی بین دقت استدلال مدل و هزینههای زمانی و مالی پروژه خود برقرار کنید. آرام گرفتن و گامبهگام اندیشیدن، در دنیای سیلیکون نیز مانند جهان انسانها کارساز است و به ما یادآوری میکند که برای رسیدن به اهداف بزرگتر، مکث کردن و بازنگری در گامها ارزش بالایی دارد. این ابزار به ما قدرت میدهد تا پایداری و صحت پاسخهای دریافتی را تا حد چشمگیری بهبود بخشیم و عاملهای منطقیتری بسازیم.
آیا تا به حال در پروژههای خود از تکنیکهای زنجیره اندیشه استفاده کردهاید؟ تجربیات خود را در مورد نرخ خطای محاسباتی مدلها با ما در بخش نظرات به اشتراک بگذارید تا راهحلهای نوین را با هم به بحث بگذاریم و یادگیری را عمیقتر کنیم.