۱. قلمرو نمونهها: چگونه با مثال زدن، هوش مصنوعی را رام کنیم؟
در دنیای امروز که هوش مصنوعی و به خصوص مدلهای زبانی بزرگ (LLMs) بخش عمدهای از فناوریهای نوین را به خود اختصاص دادهاند، نحوه تعامل ما با این سیستمها بسیار حیاتی است. تصور کنید به یک همکار جدید میخواهید وظیفهای را محول کنید. اگر تنها با چند کلمه کوتاه از او بخواهید که کار را انجام دهد، احتمالا نتیجه مطلوبی نخواهید گرفت. اما اگر با استفاده از مثالها و نمونههای دقیق به او نشان دهید که دقیقاً چه چیزی از او میخواهید، نتیجه کار به مراتب بهتر خواهد بود. این دقیقاً همان مفهومی است که در دنیای مهندسی پرامپت با عنوان Few-Shot و Zero-Shot Prompting شناخته میشود.
در این روشها، ما به جای استفاده از دستورات خشک و مبهم، با ارائه الگوهای مشخص و مثالهای واقعی، مسیر تفکر و پاسخدهی مدل را هدایت میکنیم. این کار نهتنها دقت خروجی را به شدت افزایش میدهد، بلکه نیاز به تنظیمات پیچیده و تغییر در معماری یا وزنهای شبکههای عصبی را نیز از بین میبرد. در واقع، ما با زبانی که مدل بهتر میفهمد، یعنی زبان الگوها و مثالها، با آن صحبت میکنیم.
زمانی که یک مدل با میلیاردها پارامتر آموزش داده میشود، دارای دانش نهفتهای است که برای استخراج آن نیاز به کلید مناسب داریم. این کلید چیزی نیست جز پرامپتهای مهندسی شده. با ورود به قلمرو نمونهها، ما از یک مصرفکننده ساده به یک معمار تعامل تبدیل میشویم که میتواند پیچیدهترین مسائل را با استفاده از الگوهای مناسب حل کند. در ادامه این مقاله، به بررسی عمیق این دو مکتب پرامپتنویسی خواهیم پرداخت و با مثالهای عملی، نحوه پیادهسازی آنها را در پروژههای واقعی نشان خواهیم داد.
۲. کالبدشکافی یادگیری درونبافتی: ترنسفورمرها چگونه بدون تغییر وزنها یاد میگیرند؟
برای درک بهتر نحوه عملکرد Few-Shot و Zero-Shot Prompting، ابتدا باید با مفهومی به نام یادگیری درونبافتی (In-Context Learning) آشنا شویم. برخلاف روشهای سنتی یادگیری ماشین که در آنها برای یادگیری یک وظیفه جدید، نیاز به بهروزرسانی وزنها (Weights) و پارامترهای شبکه از طریق فرآیندهای بهینهسازی مانند Gradient Descent داریم، یادگیری درونبافتی به مدل اجازه میدهد تا تنها با تکیه بر اطلاعات موجود در پرامپت، وظیفه جدید را یاد بگیرد و انجام دهد.
مدلهای ترنسفورمر (Transformers) مانند سری GPT، در طول فرآیند پیشآموزش (Pre-training) روی حجم عظیمی از دادههای متنی، الگوهای زبانی، ساختارهای گرامری، و روابط معنایی را یاد میگیرند. این مدلها به گونهای آموزش دیدهاند که کلمه بعدی را بر اساس کلمات قبلی پیشبینی کنند. زمانی که ما چند مثال در پرامپت خود قرار میدهیم، مدل از مکانیزم توجه (Attention Mechanism) خود برای استخراج الگوهای پنهان در آن مثالها استفاده میکند.
در واقع، مدل وزنهای خود را تغییر نمیدهد، بلکه از حالتهای موقت (Transient States) ایجاد شده در طول پردازش پرامپت، برای تنظیم خروجی خود در همان لحظه استفاده میکند. این ویژگی شگفتانگیز باعث میشود که مدل بتواند به سرعت با وظایف جدید سازگار شود، بدون اینکه نیاز به هزینههای سنگین پردازشی برای آموزش مجدد داشته باشد. این همان رازی است که الگوهای پرامپتنویسی حرفهای را تا این حد قدرتمند و انعطافپذیر میسازد.
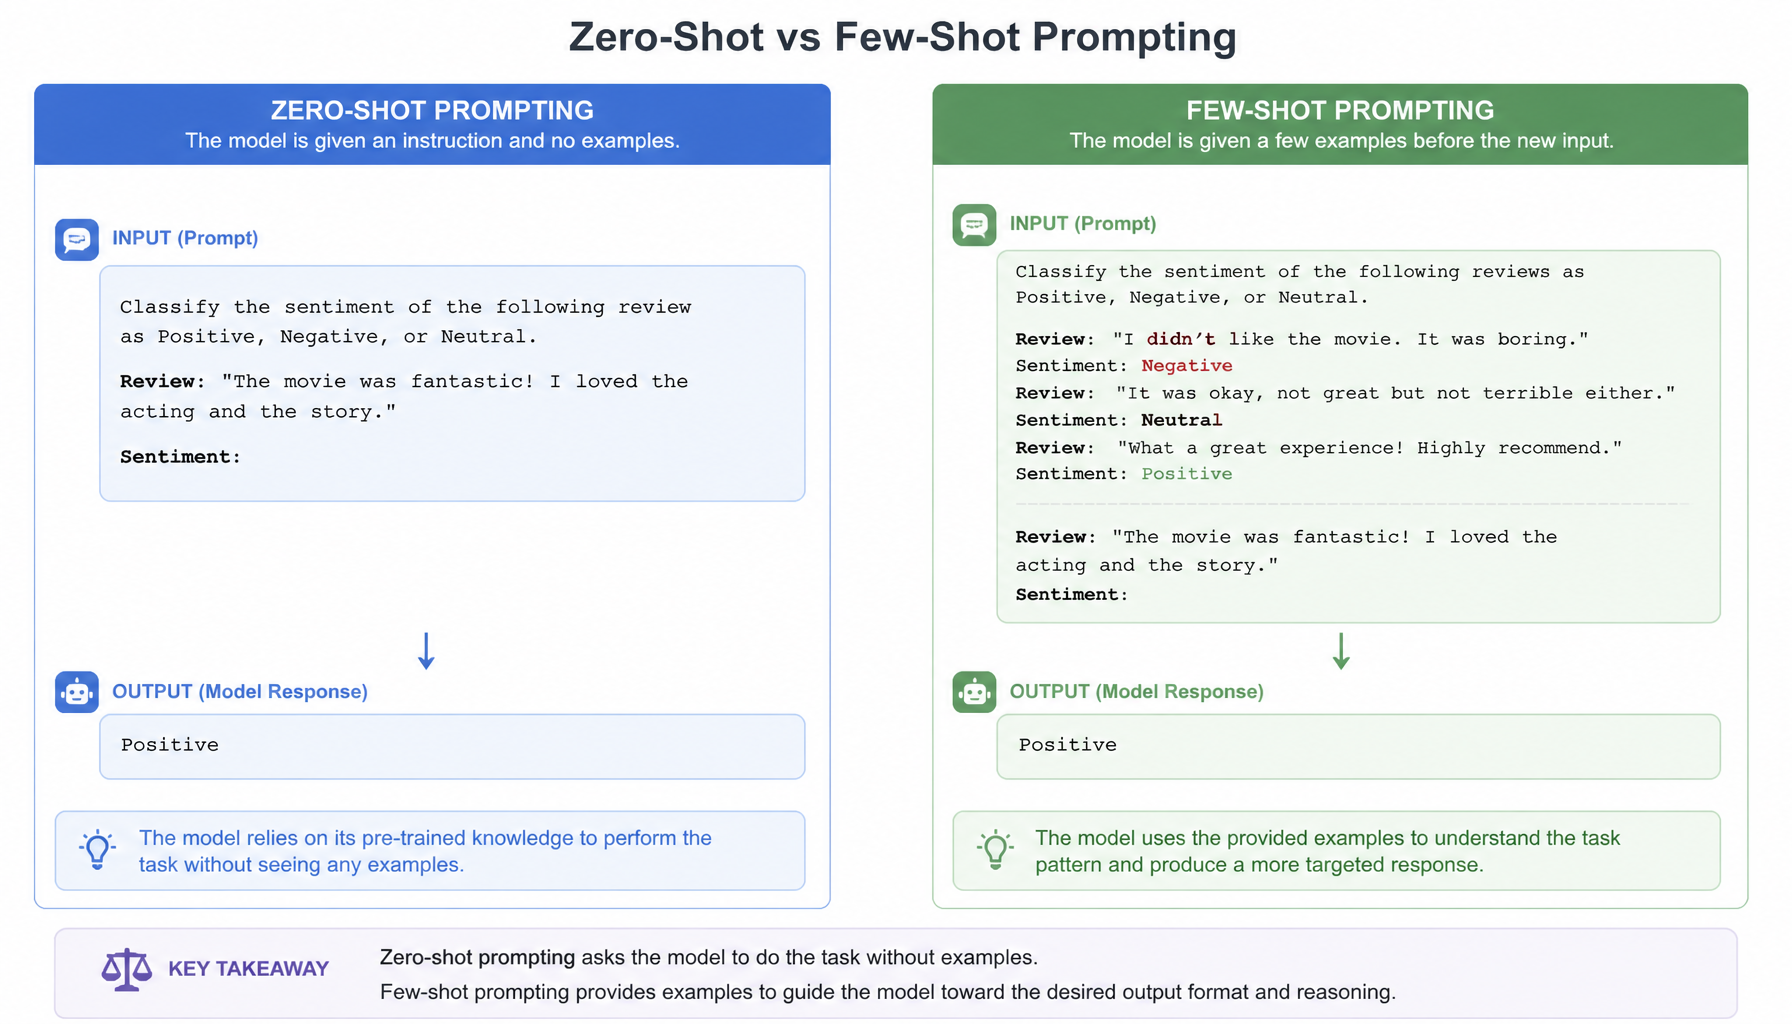
تصویر ۱: مقایسه بصری بین ساختار پرامپتهای Zero-Shot و Few-Shot
۳. مکتب صفرنمونهای: جادوی تکیه بر دانش پیشفرض
روش Zero-Shot Prompting، سادهترین و در عین حال یکی از قدرتمندترین روشهای تعامل با مدلهای زبانی است. در این مکتب، ما بدون ارائه هیچگونه مثال یا نمونه قبلی، مستقیماً از مدل میخواهیم که وظیفهای را انجام دهد. این روش کاملاً بر دانش پیشفرض مدل که در طول فاز پیشآموزش کسب کرده است، تکیه دارد.
تصور کنید از یک مدل زبانی میخواهید که یک متن انگلیسی را به فارسی ترجمه کند. شما فقط متن اصلی را به مدل میدهید و از او میخواهید ترجمه را انجام دهد. از آنجایی که مدل در طول آموزش خود با میلیونها متن دوزبانه مواجه شده است، میتواند بدون نیاز به مثال، این کار را به خوبی انجام دهد. این روش برای وظایفی که در مجموعه دادههای آموزشی مدل به وفور یافت میشوند، بسیار کارآمد است.
- مزایا: سادگی در پیادهسازی، مصرف کمتر توکنها (کاهش هزینه)، و سرعت بالای پردازش.
- معایب: در وظایف پیچیده، مبهم یا بسیار تخصصی، ممکن است مدل دچار توهم (Hallucination) شود یا خروجی با فرمت دلخواه شما را تولید نکند.
برای استفاده بهینه از این روش، پرامپت شما باید بسیار دقیق، شفاف و بدون ابهام باشد. استفاده از دستورات مشخص و تعریف نقش (Role Prompting) میتواند اثربخشی روش Zero-Shot را تا حد زیادی افزایش دهد.
۴. مکتب چندنمونهای: ساختاردهی به خروجیها با الگوهای نمونه
هنگامی که با وظایف پیچیدهتری مواجه میشویم یا نیاز داریم که خروجی مدل در یک فرمت خاص (مانند JSON، XML یا یک ساختار متنی مشخص) تولید شود، روش Zero-Shot ممکن است پاسخگو نباشد. در این شرایط، مکتب Few-Shot Prompting به کمک ما میآید. در این روش، ما پیش از درخواست نهایی، چند نمونه از ورودیها و خروجیهای مطلوب را در پرامپت قرار میدهیم تا مدل الگوی مورد نظر ما را درک کند.
تعداد مثالها میتواند از یک (One-Shot) تا دهها مثال متغیر باشد. با ارائه این مثالها، ما در واقع به مدل نشان میدهیم که "منظور من دقیقاً این است". مدل با بررسی این الگوها، متوجه میشود که چه نوع استدلالی باید به کار ببرد و خروجی نهایی را در چه قالبی ارائه دهد.
به عنوان مثال، فرض کنید میخواهیم از مدل برای طبقهبندی نظرات کاربران به دستههای مثبت، منفی و خنثی استفاده کنیم. با ارائه چند مثال از نظرات و برچسبهای آنها، مدل به سرعت یاد میگیرد که چگونه باید نظرات جدید را ارزیابی کند. این روش به خصوص برای استخراج اطلاعات ساختاریافته از متون بدون ساختار، کاربرد فراوانی دارد.
۵. روشهای پیشرفته: ترکیب Few-Shot با استدلال زنجیرهای
با وجود قدرت بالای روش Few-Shot، گاهی اوقات مدل در حل مسائل ریاضی پیچیده یا استدلالهای منطقی چند مرحلهای دچار مشکل میشود. در اینجا است که ترکیبی از Few-Shot و تکنیک Chain-of-Thought (CoT) میتواند معجزه کند. در این روش ترکیبی، ما نه تنها نمونههایی از ورودی و خروجی نهایی را ارائه میدهیم، بلکه مراحل رسیدن به پاسخ را نیز در مثالها میگنجانیم.
با این کار، مدل یاد میگیرد که برای رسیدن به پاسخ نهایی، باید مسئله را به مراحل کوچکتر تقسیم کرده و قدم به قدم استدلال کند. این رویکرد به طور چشمگیری عملکرد مدل را در حل مسائل استدلالی و منطقی بهبود میبخشد. به جای اینکه از مدل بخواهیم مستقیماً به جواب برسد، از او میخواهیم که "بلند فکر کند" و مراحل استدلال خود را نشان دهد.
۶. یک کلاس پایتون برای تزریق خودکار مثالها به پرامپتها
برای اینکه بتوانیم این مفاهیم را در پروژههای واقعی و سیستمهای نرمافزاری خود پیادهسازی کنیم، نیاز به ساختاردهی کدهایمان داریم. در ادامه، یک کلاس پایتون ساده اما کاربردی را معرفی میکنیم که میتواند فرآیند ساخت پرامپتهای Few-Shot را به صورت خودکار و داینامیک انجام دهد. این کلاس به شما اجازه میدهد تا مثالها را مدیریت کرده و در زمان اجرا، پرامپت نهایی را تولید کنید.
class PromptBuilder:
def __init__(self, system_instruction: str):
self.system_instruction = system_instruction
self.examples = []
def add_example(self, user_input: str, model_output: str):
self.examples.append({
"input": user_input,
"output": model_output
})
def build_prompt(self, final_input: str) -> str:
prompt = f"{self.system_instruction}\n\n"
if self.examples:
prompt += "Examples:\n"
for i, ex in enumerate(self.examples, 1):
prompt += f"--- Example {i} ---\n"
prompt += f"Input: {ex['input']}\n"
prompt += f"Output: {ex['output']}\n\n"
prompt += "--- Task ---\n"
prompt += f"Input: {final_input}\n"
prompt += "Output:"
return prompt
# استفاده از کلاس برای ساخت یک پرامپت Few-Shot
builder = PromptBuilder("شما یک دستیار هوشمند برای تحلیل احساسات جملات هستید. خروجی باید فقط یکی از کلمات 'مثبت'، 'منفی' یا 'خنثی' باشد.")
# افزودن مثالها
builder.add_example("این محصول واقعا شگفتانگیز بود و خیلی راضی هستم.", "مثبت")
builder.add_example("کیفیت ساخت بسیار پایین است و اصلا ارزش خرید ندارد.", "منفی")
builder.add_example("رنگ آن با چیزی که در عکس دیدم کمی متفاوت بود.", "خنثی")
# تولید پرامپت نهایی
final_prompt = builder.build_prompt("بستهبندی خیلی ضعیف بود ولی خود دستگاه خوب کار میکنه.")
print(final_prompt)
با استفاده از این کلاس، شما میتوانید به راحتی مثالهای خود را مدیریت کرده و پرامپتهایی ساختاریافته تولید کنید. این روش به خصوص زمانی که میخواهید سیستم خود را مقیاسپذیر کنید و از الگوهای مختلفی برای وظایف گوناگون استفاده کنید، بسیار مفید است. شما میتوانید این کلاس را گسترش دهید و ویژگیهایی مانند مدیریت محدودیت توکنها را نیز به آن اضافه کنید.
۷. کلام پایانی: نمونهها، معماران مسیر
در دنیای پرشتاب هوش مصنوعی، تسلط بر تکنیکهای پرامپتنویسی مانند Few-Shot و Zero-Shot دیگر یک مهارت جانبی نیست، بلکه یک ضرورت است. این تکنیکها به ما اجازه میدهند تا از حداکثر تواناییهای مدلهای زبانی استفاده کنیم و خروجیهایی دقیق، ساختاریافته و قابل اعتماد دریافت نماییم. در حالی که Zero-Shot ما را قادر میسازد تا وظایف ساده و عمومی را با سرعت بالا انجام دهیم، Few-Shot ابزاری است برای غلبه بر چالشهای پیچیدهتر و تخصصیتر.
در نهایت، باید به یاد داشته باشیم که هوش مصنوعی تنها به اندازه دستوراتی که به آن میدهیم هوشمند است. با انتخاب درست بین روشهای مختلف پرامپتنویسی و ترکیب آنها با تکنیکهای پیشرفتهتر مانند Chain-of-Thought، میتوانیم راهکارهایی قدرتمند و نوآورانه برای حل مسائل در حوزههای مختلف خلق کنیم. نمونههایی که ما به مدل ارائه میدهیم، در واقع معماران مسیری هستند که هوش مصنوعی در آن قدم میگذارد.
همانطور که دیدید، با استفاده از چند خط کد پایتون، میتوانیم این مفاهیم انتزاعی را به ابزارهایی ملموس در نرمافزارهای خود تبدیل کنیم. امید است که این راهنما بتواند دید بهتری نسبت به نحوه تعامل موثرتر با مدلهای زبانی بزرگ به شما ارائه دهد و در پروژههای آیندهتان راهگشا باشد.
۸. مقایسه عمیق: Zero-Shot در برابر Few-Shot
هنگامی که تصمیم میگیریم از کدام رویکرد استفاده کنیم، باید چندین فاکتور اساسی را در نظر بگیریم. روش Zero-Shot به دلیل عدم نیاز به مثال، در مصرف توکنها بسیار صرفهجویی میکند. این موضوع مخصوصاً زمانی اهمیت پیدا میکند که از APIهای تجاری با هزینه بر اساس توکن استفاده میکنیم. از سوی دیگر، Few-Shot با مصرف توکنهای بیشتر، دقت فوقالعاده بالاتری در فرمتبندی و درک ظرافتهای مسئله ارائه میدهد.
در کاربردهایی مانند تحلیل احساسات (Sentiment Analysis)، استخراج موجودیتهای نامدار (NER) و پاسخ به سوالات از روی متن (Q&A)، تفاوت عملکرد این دو روش بسیار مشهود است. برای مثال، اگر بخواهیم نام شرکتها را از یک متن استخراج کنیم، مدل در حالت Zero-Shot ممکن است نام محصولات یا افراد را نیز به اشتباه برگرداند. اما با ارائه تنها ۳ الی ۵ مثال دقیق در حالت Few-Shot، مدل کاملاً متوجه مرزبندی موجودیتها میشود.
علاوه بر این، انتخاب بین این دو روش به قدرت ذاتی مدل نیز بستگی دارد. مدلهای بسیار بزرگ با پارامترهای بالا (مانند GPT-4) در حالت Zero-Shot عملکرد خیرهکنندهای دارند و اغلب نیاز به مثال ندارند، در حالی که مدلهای کوچکتر و منبعباز (مانند Llama-2-7B) وابستگی شدیدی به Few-Shot برای تولید خروجیهای ساختاریافته دارند.
۹. چالشها و محدودیتهای یادگیری درونبافتی
علیرغم تمام مزایا، این روشها دارای محدودیتهای خاص خود هستند. یکی از بزرگترین چالشها در Few-Shot، وابستگی شدید خروجی به نحوه چینش و انتخاب مثالهاست. اگر مثالهایی که انتخاب میکنید دارای سوگیری (Bias) باشند یا تمام حالات ممکن مسئله را پوشش ندهند، مدل دقیقاً همان سوگیری را یاد گرفته و در خروجی منعکس میکند.
چالش دیگر، محدودیت طول پنجره بافت (Context Window) مدلها است. اگر بخواهید مثالهای طولانی و زیادی ارائه دهید، ممکن است فضای کافی برای درخواست اصلی باقی نماند یا هزینه پردازش به شدت بالا برود. در این شرایط، تکنیکهایی مانند Retrieval-Augmented Generation (RAG) میتوانند به کمک بیایند تا فقط مثالهای مرتبط را به صورت پویا (Dynamic) در پرامپت تزریق کنند.
همچنین پدیده "توجه بیش از حد به مثالهای آخر" (Recency Bias) نیز در مدلهای زبانی مشاهده شده است. به این معنا که مدل ممکن است به آخرین مثال ارائه شده در پرامپت وزن بیشتری بدهد و پاسخ نهایی خود را بیشتر شبیه به آن تولید کند. برای غلبه بر این مشکل، تنوعبخشی به مثالها و تغییر ترتیب آنها در درخواستهای مختلف پیشنهاد میشود.
۱۰. مقایسه یادگیری درونبافتی با Fine-Tuning
سوالی که اغلب مطرح میشود این است: چه زمانی باید از Few-Shot استفاده کنیم و چه زمانی به سراغ Fine-Tuning (تنظیم دقیق) برویم؟ Fine-Tuning نیازمند تغییر وزنهای مدل عصبی با استفاده از یک مجموعه داده آموزشی شامل صدها یا هزاران نمونه است. این کار از نظر پردازشی هزینهبر و زمانبر است.
به طور کلی، Few-Shot برای زمانی مناسب است که دادههای آموزشی کمی داریم (کمتر از ۱۰۰ نمونه) و میخواهیم به سرعت یک نمونه اولیه (Prototype) بسازیم یا مسئله به قدری پویا است که نمیتوانیم دائماً مدل را آموزش دهیم. اما اگر به یک عملکرد پایدار در مقیاس صنعتی (Production) نیاز داریم و هزاران داده برچسبدار در اختیار داریم، Fine-Tuning انتخاب بسیار منطقیتری است، زیرا وابستگی به طول پرامپت را کاهش داده و سرعت پاسخدهی را نیز بهبود میبخشد.
جالب است بدانید که امروزه رویکرد ترکیبی نیز بسیار محبوب شده است. ابتدا با Few-Shot مسئله را حل کرده و داده تولید میکنند، سپس از این دادهها برای Fine-Tuning یک مدل کوچکتر و سریعتر استفاده میکنند تا هم به دقت بالا و هم به هزینه پایین دست یابند.
۱۱. کاربردهای پیشرفته در استخراج داده (Data Extraction)
یکی از مهمترین کاربردهای Few-Shot Prompting، تبدیل متون بدون ساختار به دادههای ساختاریافته (مانند JSON) است. فرض کنید هزاران فاکتور خرید یا رزومه کاری دارید و میخواهید اطلاعات آنها را استخراج کنید. با ارائه چند نمونه رزومه در پرامپت به همراه خروجی JSON مطلوب، مدل زبانی با دقت بالایی میتواند این الگو را تکرار کند.
این کاربرد در خودکارسازی فرآیندهای اداری (RPA) انقلاب بزرگی ایجاد کرده است. بدون نیاز به نوشتن کدهای پیچیده با عبارات باقاعده (Regex) یا ساخت مدلهای اختصاصی پردازش زبان طبیعی (NLP)، یک توسعهدهنده به تنهایی میتواند با مهندسی پرامپت، سیستمی بسازد که اطلاعات نامنظم را با دقت یک انسان متخصص طبقهبندی و مرتب کند.
۱۲. هنر طراحی مثالها در پرامپت
طراحی مثال برای Few-Shot نیازمند دقت ویژه است. مثالها باید متنوع، نماینده واقعی فضای مسئله و دارای لبههای مرزی (Edge Cases) باشند. اگر فقط مثالهای ساده را به مدل بدهید، در مواجهه با یک حالت پیچیده دچار مشکل خواهد شد. تنوع در مثالها باعث میشود مدل درک عمیقتری از فضای احتمالات پیدا کند و خروجیهایی قابل اتکاتر تولید نماید.
در نهایت، مهندسی پرامپت مانند یادگیری زبان جدیدی است که با آن میتوانیم با مغز سیلیکونی ماشینها ارتباط برقرار کنیم. تسلط بر Few-Shot و Zero-Shot، شما را از یک برنامهنویس ساده به یک ارکستراتور هوش مصنوعی تبدیل میکند که میتواند با کلمات، راهحلهایی قدرتمند برای چالشهای پیچیده نرمافزاری خلق نماید. مسیر پیشرفت در این حوزه، از طریق تمرین مداوم و آزمون و خطای الگوهای مختلف میگذرد.
۸. بررسی تخصصیتر: Zero-Shot در برابر Few-Shot
هنگامی که تصمیم میگیریم از کدام رویکرد استفاده کنیم، باید چندین فاکتور اساسی را در نظر بگیریم. روش Zero-Shot به دلیل عدم نیاز به مثال، در مصرف توکنها بسیار صرفهجویی میکند. این موضوع مخصوصاً زمانی اهمیت پیدا میکند که از APIهای تجاری با هزینه بر اساس توکن استفاده میکنیم. از سوی دیگر، Few-Shot با مصرف توکنهای بیشتر، دقت فوقالعاده بالاتری در فرمتبندی و درک ظرافتهای مسئله ارائه میدهد.
در کاربردهایی مانند تحلیل احساسات (Sentiment Analysis)، استخراج موجودیتهای نامدار (NER) و پاسخ به سوالات از روی متن (Q&A)، تفاوت عملکرد این دو روش بسیار مشهود است. برای مثال، اگر بخواهیم نام شرکتها را از یک متن استخراج کنیم، مدل در حالت Zero-Shot ممکن است نام محصولات یا افراد را نیز به اشتباه برگرداند. اما با ارائه تنها ۳ الی ۵ مثال دقیق در حالت Few-Shot، مدل کاملاً متوجه مرزبندی موجودیتها میشود.
علاوه بر این، انتخاب بین این دو روش به قدرت ذاتی مدل نیز بستگی دارد. مدلهای بسیار بزرگ با پارامترهای بالا (مانند GPT-4) در حالت Zero-Shot عملکرد خیرهکنندهای دارند و اغلب نیاز به مثال ندارند، در حالی که مدلهای کوچکتر و منبعباز (مانند Llama-2-7B) وابستگی شدیدی به Few-Shot برای تولید خروجیهای ساختاریافته دارند.
۹. مشکلات و محدودیتهای یادگیری درونبافتی
علیرغم تمام مزایا، این روشها دارای محدودیتهای خاص خود هستند. یکی از بزرگترین مشکلات در Few-Shot، وابستگی شدید خروجی به نحوه چینش و انتخاب مثالهاست. اگر مثالهایی که انتخاب میکنید دارای سوگیری (Bias) باشند یا تمام حالات ممکن مسئله را پوشش ندهند، مدل دقیقاً همان سوگیری را یاد گرفته و در خروجی منعکس میکند.
چالش دیگر، محدودیت طول پنجره بافت (Context Window) مدلها است. اگر بخواهید مثالهای طولانی و زیادی ارائه دهید، ممکن است فضای کافی برای درخواست اصلی باقی نماند یا هزینه پردازش به شدت بالا برود. در این شرایط، تکنیکهایی مانند Retrieval-Augmented Generation (RAG) میتوانند به کمک بیایند تا فقط مثالهای مرتبط را به صورت پویا (Dynamic) در پرامپت تزریق کنند.
همچنین پدیده "توجه بیش از حد به مثالهای آخر" (Recency Bias) نیز در مدلهای زبانی مشاهده شده است. به این معنا که مدل ممکن است به آخرین مثال ارائه شده در پرامپت وزن بیشتری بدهد و پاسخ نهایی خود را بیشتر شبیه به آن تولید کند. برای غلبه بر این مشکل، تنوعبخشی به مثالها و تغییر ترتیب آنها در درخواستهای مختلف پیشنهاد میشود.
۱۰. مقایسه یادگیری درونبافتی با Fine-Tuning
سوالی که اغلب مطرح میشود این است: چه زمانی باید از Few-Shot استفاده کنیم و چه زمانی به سراغ Fine-Tuning (تنظیم دقیق) برویم؟ Fine-Tuning نیازمند تغییر وزنهای مدل عصبی با استفاده از یک مجموعه داده آموزشی شامل صدها یا هزاران نمونه است. این کار از نظر پردازشی هزینهبر و زمانبر است.
به طور کلی، Few-Shot برای زمانی مناسب است که دادههای آموزشی کمی داریم (کمتر از ۱۰۰ نمونه) و میخواهیم به سرعت یک نمونه اولیه (Prototype) بسازیم یا مسئله به قدری پویا است که نمیتوانیم دائماً مدل را آموزش دهیم. اما اگر به یک عملکرد پایدار در مقیاس صنعتی (Production) نیاز داریم و هزاران داده برچسبدار در اختیار داریم، Fine-Tuning انتخاب بسیار منطقیتری است، زیرا وابستگی به طول پرامپت را کاهش داده و سرعت پاسخدهی را نیز بهبود میبخشد.
جالب است بدانید که امروزه رویکرد ترکیبی نیز بسیار محبوب شده است. ابتدا با Few-Shot مسئله را حل کرده و داده تولید میکنند، سپس از این دادهها برای Fine-Tuning یک مدل کوچکتر و سریعتر استفاده میکنند تا هم به دقت بالا و هم به هزینه پایین دست یابند.
۱۱. کاربردهای پیشرفته در استخراج داده (Data Extraction)
یکی از مهمترین کاربردهای Few-Shot Prompting، تبدیل متون بدون ساختار به دادههای ساختاریافته (مانند JSON) است. فرض کنید هزاران فاکتور خرید یا رزومه کاری دارید و میخواهید اطلاعات آنها را استخراج کنید. با ارائه چند نمونه رزومه در پرامپت به همراه خروجی JSON مطلوب، مدل زبانی با دقت بالایی میتواند این الگو را تکرار کند.
این کاربرد در خودکارسازی فرآیندهای اداری (RPA) انقلاب بزرگی ایجاد کرده است. بدون نیاز به نوشتن کدهای پیچیده با عبارات باقاعده (Regex) یا ساخت مدلهای اختصاصی پردازش زبان طبیعی (NLP)، یک توسعهدهنده به تنهایی میتواند با مهندسی پرامپت، سیستمی بسازد که اطلاعات نامنظم را با دقت یک انسان متخصص طبقهبندی و مرتب کند.
۱۲. هنر طراحی مثالها در پرامپت
طراحی مثال برای Few-Shot نیازمند دقت ویژه است. مثالها باید متنوع، نماینده واقعی فضای مسئله و دارای لبههای مرزی (Edge Cases) باشند. اگر فقط مثالهای ساده را به مدل بدهید، در مواجهه با یک حالت پیچیده دچار مشکل خواهد شد. تنوع در مثالها باعث میشود مدل درک عمیقتری از فضای احتمالات پیدا کند و خروجیهایی قابل اتکاتر تولید نماید.
در نهایت، مهندسی پرامپت مانند یادگیری زبان جدیدی است که با آن میتوانیم با مغز سیلیکونی ماشینها ارتباط برقرار کنیم. تسلط بر Few-Shot و Zero-Shot، شما را از یک برنامهنویس ساده به یک ارکستراتور هوش مصنوعی تبدیل میکند که میتواند با کلمات، راهحلهایی قدرتمند برای مشکلاتی پیچیده نرمافزاری خلق نماید. مسیر پیشرفت در این حوزه، از طریق تمرین مداوم و آزمون و خطای الگوهای مختلف میگذرد.