۱. از صفر تا پاسخ: سفرنامه ساخت یک مغز جستجوگر
در دنیای امروز هوش مصنوعی، مدلهای زبانی بزرگ (LLM) به تنهایی قادر به حل تمام مشکلات نیستند. آنها با مشکلاتی نظیر توهم (Hallucination) و عدم دسترسی به دادههای بهروز و اختصاصی دستوپنجه نرم میکنند. اینجاست که سیستمهای RAG (Retrieval-Augmented Generation) وارد میدان میشوند. اگر میخواهید با مفاهیم پایه مدلها بیشتر آشنا شوید، حتما مقاله پارامتر، توکن و پنجره زمینه را مطالعه کنید.
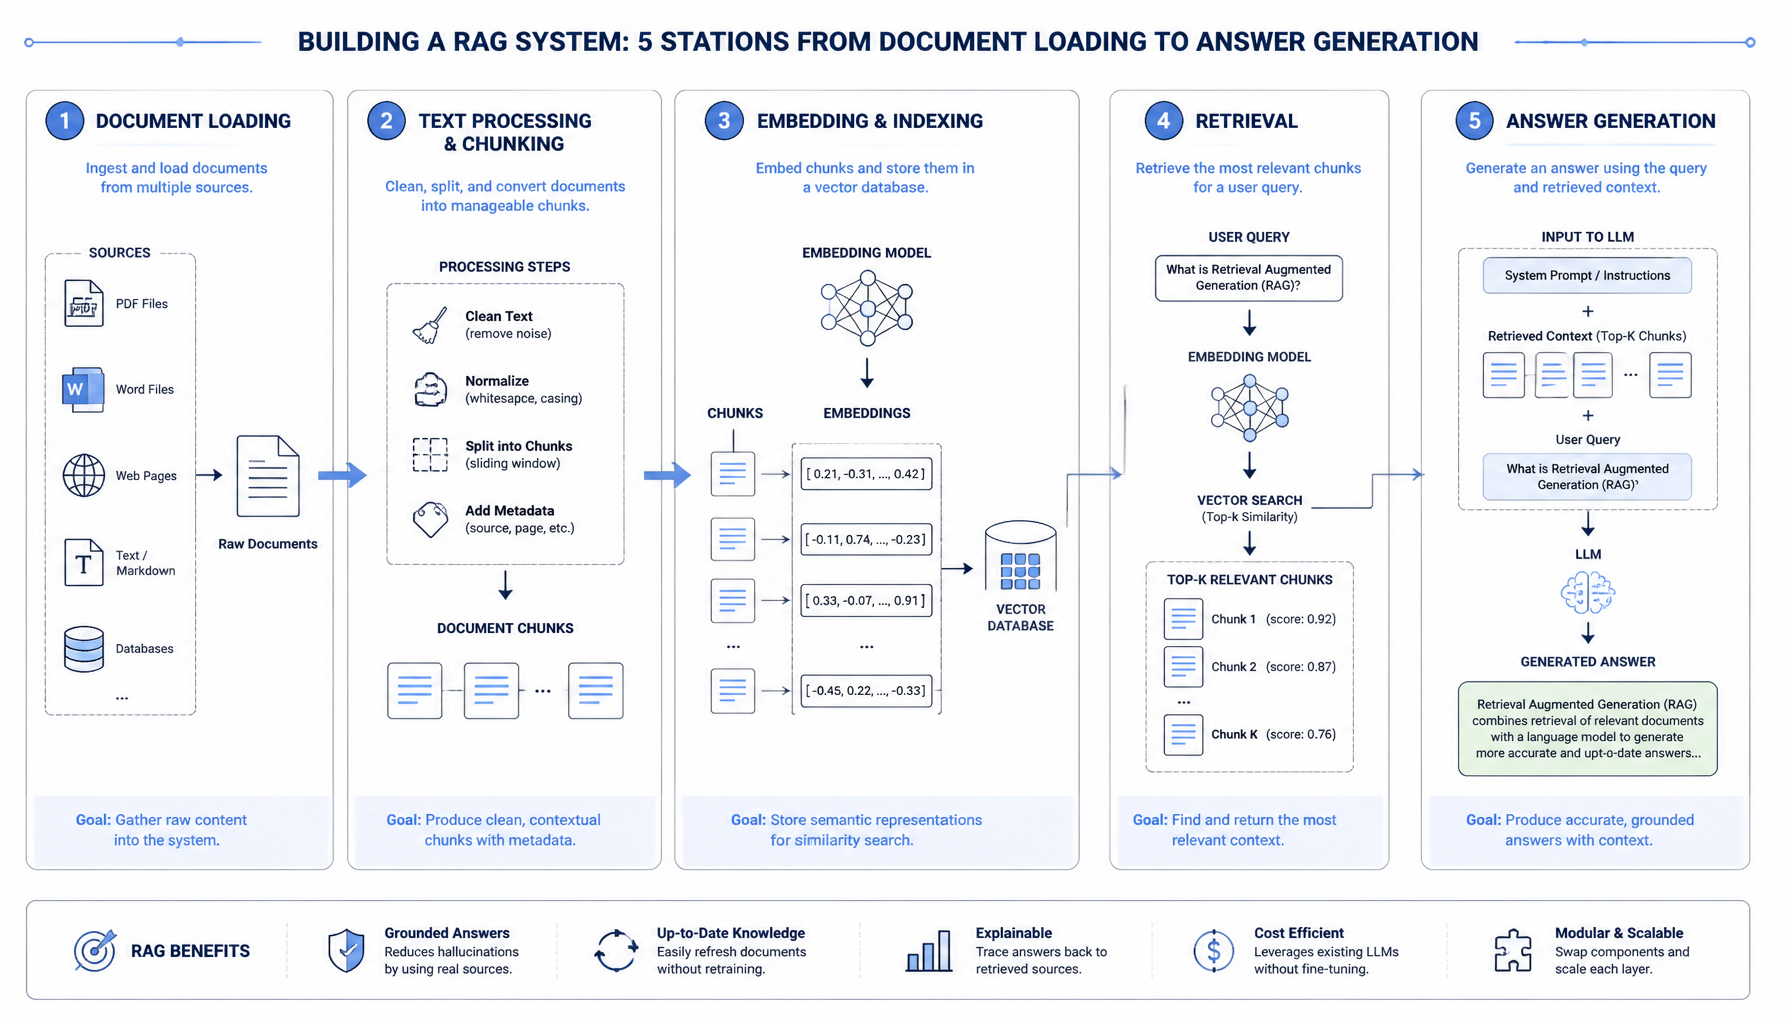
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
سیستم RAG به ما اجازه میدهد تا دانش اختصاصی خود را به مدل تزریق کنیم، بدون اینکه نیازی به آموزش مجدد (Fine-tuning) مدل داشته باشیم. این رویکرد به شدت در هزینهها صرفهجویی میکند و نتایج بسیار دقیقتری ارائه میدهد. برای درک بهتر بهینهسازی مدلها نیز میتوانید به مقاله Quantization چیست مراجعه کنید.
۲. ایستگاه اول: آمادهسازی محیط توسعه و وابستگیها
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
اولین قدم در هر پروژه نرمافزاری، آمادهسازی محیط و نصب ابزارهای مورد نیاز است. برای ساخت یک سیستم RAG کارآمد، ما از پایتون به عنوان زبان اصلی استفاده خواهیم کرد. کتابخانههای کلیدی شامل LangChain برای ارکستراسیون، ChromaDB برای دیتابیس برداری و OpenAI برای مدلهای زبانی است. در این ایستگاه ما یاد میگیریم چگونه محیط مجازی (Virtual Environment) را راهاندازی کرده و وابستگیها را مدیریت کنیم.
۳. ایستگاه دوم: بارگذاری و تکهبندی اسناد
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
اسناد متنی، پیدیافها، صفحات وب و دادههای سازمانی همگی میتوانند به عنوان منابع دانش مورد استفاده قرار گیرند. اما مدلهای زبانی دارای محدودیت در پنجره زمینه (Context Window) هستند. بنابراین نمیتوانیم تمام اسناد را یکباره به مدل بدهیم. راه حل چیست؟ تکهبندی یا Chunking! در این ایستگاه با روشهای مختلف بارگذاری اسناد و استراتژیهای هوشمندانه تکهبندی متن آشنا میشویم تا هم معنای جملات حفظ شود و هم محدودیتهای مدل رعایت گردد.
۴. ایستگاه سوم: تبدیل تکهها به بردار و ذخیره در دیتابیس برداری
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
کامپیوترها کلمات را نمیفهمند، بلکه اعداد را میفهمند. برای اینکه سیستم بتواند ارتباط معنایی بین پرسش کاربر و تکههای متنی را درک کند، باید متنها را به بردارهای عددی (Embeddings) تبدیل کنیم. پس از تولید بردارها، آنها را در یک دیتابیس برداری (Vector Database) مانند ChromaDB ذخیره میکنیم تا در زمان جستجو بتوانیم با محاسبه شباهت کسینوسی (Cosine Similarity)، نزدیکترین تکههای متنی به پرسش کاربر را در کسری از ثانیه پیدا کنیم.
۵. ایستگاه چهارم: ساخت زنجیره بازیابی و تولید پاسخ
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
اکنون که دادههای ما برداری شده و در پایگاه داده قرار دارند، زمان آن است که پرسش کاربر را دریافت کنیم، آن را به بردار تبدیل کنیم و در پایگاه داده جستجو نماییم. سپس تکههای مرتبط یافتشده را به همراه پرسش اصلی به یک 프رومپت (Prompt) مناسب تزریق کرده و به مدل زبانی ارسال کنیم. برای نوشتن پرامپتهای بهتر میتوانید به مقاله ۱۰ الگوی پرامپتنویسی حرفهای نگاهی بیندازید. در اینجا از زنجیرههای LangChain استفاده میکنیم تا این فرآیندها به صورت خودکار و یکپارچه انجام شوند.
۶. ایستگاه پنجم: تست، ارزیابی و بهینهسازی
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
ساخت نسخه اولیه RAG آسان است، اما ساخت یک سیستم قابل اعتماد در محیط عملیاتی (Production) نیازمند ارزیابی و بهینهسازی مداوم است. باید متریکهایی مانند Relevance، Faithfulness و Context Recall را اندازهگیری کنیم. استفاده از تکنیکهایی نظیر Hybrid Search (ترکیب جستجوی کلیدواژهای و معنایی) و Re-ranking (رتبهبندی مجدد نتایج) میتواند دقت پاسخها را به طور چشمگیری افزایش دهد. در این بخش با ابزارهای ارزیابی RAG آشنا میشویم.
۷. کلام پایانی: از ایده تا محصول
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.
ساخت یک سیستم RAG کامل از صفر نیازمند درک عمیقی از اجزای مختلف آن از جمله نحوه بارگذاری دادهها، ساخت بردارهای معنایی، ذخیرهسازی، بازیابی و تولید پاسخ است. با استفاده از ابزارهای قدرتمندی مانند پایتون، لنگچین و دیتابیسهای برداری، توسعهدهندگان میتوانند محصولات هوش مصنوعی شگفتانگیزی بسازند که مشکلات واقعی کسبوکارها را حل میکند. این سفر تازه آغاز شده است و دنیای هوش مصنوعی هر روز شگفتیهای جدیدی برای ارائه دارد.