1. نقشه ی گنج: چرا معماری RAG مانند طراحی یک شهر هوشمند است؟
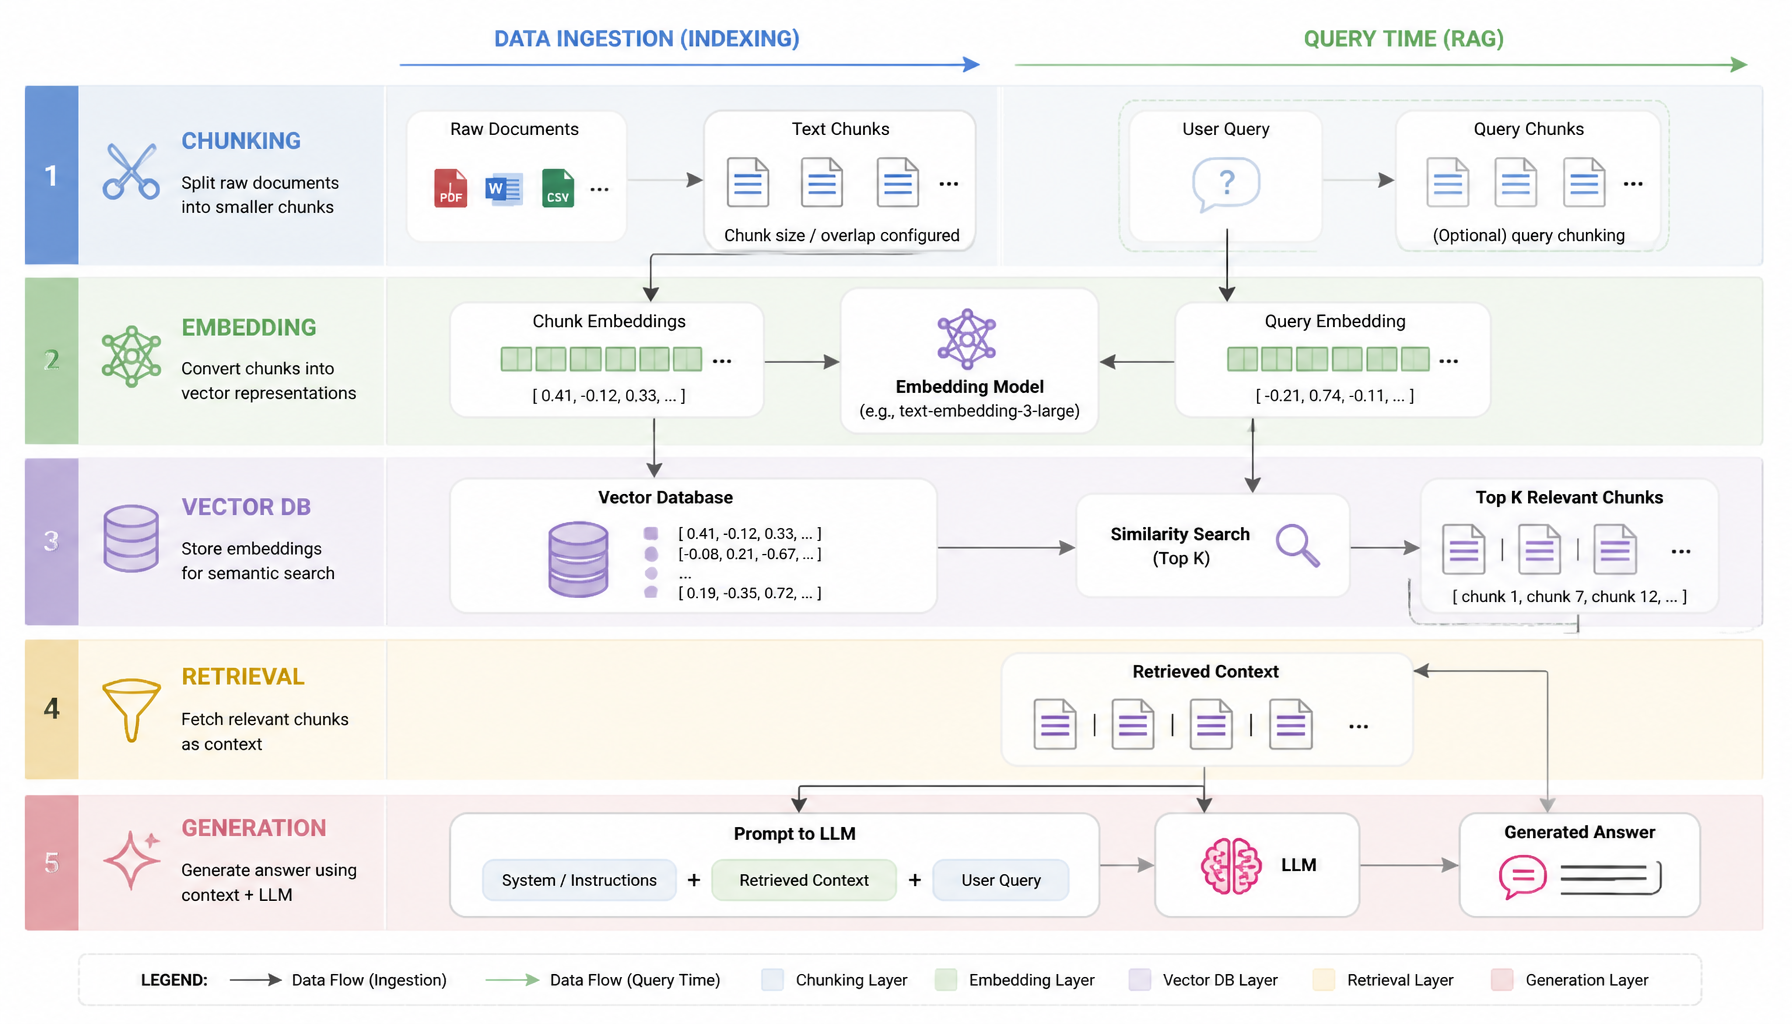
سیستمهای تولید افزوده با بازیابی (Retrieval-Augmented Generation یا به اختصار RAG) به یکی از مهمترین پیشرفتها در زمینه هوش مصنوعی تبدیل شدهاند. برای درک بهتر، تصور کنید در حال ساخت یک شهر هوشمند هستید. در این شهر، دادهها نقش شهروندان، جادهها نقش پایگاه داده، و ساختمانهای شهری نقش لایههای پردازشی را ایفا میکنند. معماری RAG دقیقاً به همین شکل عمل میکند؛ این معماری به مدلهای زبانی بزرگ اجازه میدهد تا به جای تکیه صرف بر حافظه داخلی (پنجره زمینه و پارامترها که در مقاله پارامتر، توکن و پنجره زمینه بررسی کردهایم)، به منابع اطلاعاتی خارجی و بروز دسترسی پیدا کنند.
بدون وجود RAG، مدلهای زبانی مانند کتابخانهای هستند که تمام کتابهایش را خوانده و حفظ کردهاند اما نمیتوانند کتاب جدیدی را به قفسهها اضافه کنند، مگر اینکه دوباره آموزش ببینند (Fine-tuning). این محدودیت نه تنها پرهزینه است، بلکه خطر بروز پدیده توهم در LLMها را نیز به شدت افزایش میدهد. معماری RAG با اتصال مدل زبانی به یک موتور جستجوی هوشمند، این مشکل را حل میکند. این شهر هوشمند اطلاعاتی، دادههای ورودی را پردازش کرده، در مکانهای مناسب ذخیره میکند و هنگام نیاز، دقیقترین و مرتبطترین اطلاعات را برای تولید پاسخ نهایی فرا میخواند.
طراحی چنین معماری پیچیدهای نیازمند دقت فراوان در انتخاب اجزا و نحوه ارتباط آنها با یکدیگر است. هر بخش از این سیستم، از قطعهبندی اسناد گرفته تا بردارسازی و جستجو، باید با بالاترین کارایی عمل کند. اگر یکی از لایهها به درستی تنظیم نشود، کل فرآیند با مشکل مواجه خواهد شد. در ادامه این مقاله، ما به صورت گامبهگام و با جزئیات کامل، هر یک از لایههای این معماری شگفتانگیز را بررسی خواهیم کرد تا درک عمیقی از نحوه کارکرد آن به دست آورید و بتوانید سیستم RAG اختصاصی خود را با بهترین کیفیت پیادهسازی کنید.
2. لایه تکه بندی: هنر تقسیم اسناد بلند به واحدهای معنادار (Chunking)
اولین و شاید حیاتیترین مرحله در معماری RAG، فرآیند تکهبندی یا Chunking است. اسناد خام، چه فایلهای متنی طولانی باشند، چه مقالات علمی و چه کدهای برنامهنویسی، معمولاً بسیار حجیمتر از آن هستند که بتوان آنها را به طور کامل پردازش کرد یا مستقیماً به مدل زبانی ارسال نمود. هدف از Chunking، تقسیم این اسناد بزرگ به قطعات کوچکتر و قابل مدیریت است، بدون اینکه معنا و مفهوم اصلی آنها از دست برود.
روشهای مختلفی برای تکهبندی وجود دارد که هر کدام مزایا و معایب خاص خود را دارند. روش اول، تکهبندی ثابت (Fixed-size Chunking) است که در آن متن بر اساس تعداد مشخصی از کاراکترها یا توکنها تقسیم میشود. این روش ساده و سریع است اما ممکن است جملات را در وسط قطع کند و به معنای متن آسیب برساند. روش دوم، تکهبندی مبتنی بر ساختار (Structural Chunking) است که متن را بر اساس پاراگرافها، سرفصلها یا جملات تقسیم میکند. این روش معنا را بهتر حفظ میکند اما پیادهسازی آن پیچیدهتر است.
روش سوم و پیشرفتهتر، تکهبندی معنایی (Semantic Chunking) است. در این روش، از مدلهای هوش مصنوعی برای شناسایی مرزهای معنایی استفاده میشود تا قطعاتی تولید شوند که هر کدام یک ایده یا موضوع کامل را در بر میگیرند. علاوه بر روش تکهبندی، مفهوم همپوشانی (Overlap) نیز بسیار مهم است. برای جلوگیری از قطع ارتباط بین دو قطعه متوالی، معمولاً مقداری همپوشانی (مثلاً 10 تا 20 درصد) بین قطعات در نظر گرفته میشود. انتخاب اندازه مناسب برای قطعات و میزان همپوشانی، تأثیر مستقیمی بر کیفیت نتایج جستجو و پاسخ نهایی خواهد داشت و نیازمند آزمون و خطای فراوان است.
3. لایه بردارسازی: تبدیل معنا به هندسه (Embedding)
پس از اینکه اسناد به قطعات کوچکتر تقسیم شدند، مرحله بعدی تبدیل این متون به اعداد است؛ اما نه هر عددی. لایه بردارسازی (Embedding) وظیفه دارد متن را به یک بردار ریاضی در یک فضای چند بعدی تبدیل کند. این بردارها به گونهای تولید میشوند که متونی با معانی مشابه، در این فضای هندسی به یکدیگر نزدیکتر باشند. این مفهوم شالوده اصلی جستجوی معنایی را تشکیل میدهد.
مدلهای Embedding مختلفی در دسترس هستند که هر کدام ویژگیهای خاص خود را دارند. مدلهای شرکت OpenAI (مانند text-embedding-ada-002) به دلیل دقت بالا و پشتیبانی از زبانهای مختلف بسیار محبوب هستند. مدلهای متنباز مانند BGE (BAAI General Embedding) و Sentence Transformers نیز گزینههای قدرتمندی برای پیادهسازیهای محلی محسوب میشوند. انتخاب مدل مناسب، تأثیر عمیقی بر عملکرد سیستم RAG دارد. مدلی که برای متون پزشکی آموزش دیده باشد، ممکن است برای کدهای برنامهنویسی کارایی مناسبی نداشته باشد.
یکی از چالشهای اصلی در لایه بردارسازی، زبان فارسی است. بسیاری از مدلهای پیشفرض، عملکرد ایدهآلی در زبان فارسی ندارند و ممکن است نتوانند ظرافتهای معنایی را به درستی درک کنند. بنابراین، استفاده از مدلهای چندزبانه قدرتمند یا مدلهایی که به صورت خاص برای زبان فارسی Fine-tune شدهاند، بسیار حائز اهمیت است. بردارسازی تنها مختص متون ذخیره شده نیست؛ هنگامی که کاربر سؤالی را مطرح میکند، آن سؤال نیز باید توسط دقیقاً همان مدل به بردار تبدیل شود تا بتوان آن را با بردارهای ذخیره شده مقایسه کرد.
4. لایه ذخیره سازی: دیتابیس های برداری از Chroma تا Pinecone
حال که متون ما به بردارهای ریاضی تبدیل شدهاند، باید آنها را در مکانی ذخیره کنیم. پایگاههای داده سنتی (مانند SQL) برای جستجوی متنی یا مقایسه بردارها طراحی نشدهاند. اینجا است که دیتابیسهای برداری (Vector Databases) وارد میدان میشوند. این پایگاههای داده به صورت اختصاصی برای ذخیره، نمایهسازی (Indexing) و جستجوی سریع در میان میلیونها یا حتی میلیاردها بردار طراحی شدهاند.
تنوع دیتابیسهای برداری در سالهای اخیر به شدت افزایش یافته است. ChromaDB یک گزینه متنباز و بسیار سبک است که برای پروژههای کوچک و نمونههای اولیه بسیار مناسب است. Pinecone یک سرویس ابری و کاملاً مدیریت شده است که مقیاسپذیری و سرعت فوقالعادهای ارائه میدهد و برای کاربردهای تجاری بزرگ گزینهای ایدهآل است. Qdrant، Milvus و Weaviate نیز از دیگر دیتابیسهای قدرتمندی هستند که هر کدام قابلیتهای منحصر به فردی مانند فیلتر کردن پیشرفته متادیتا را ارائه میدهند.
ذخیرهسازی تنها شامل خود بردارها نیست. یکی از مهمترین بخشهای این لایه، ذخیره متادیتا (Metadata) همراه با بردارها است. متادیتا میتواند شامل عنوان سند، تاریخ نگارش، نام نویسنده و شماره صفحه باشد. در هنگام جستجو، سیستم میتواند ابتدا با استفاده از متادیتا نتایج را فیلتر کند (مثلاً فقط مقالاتی که در سال 2023 نوشته شدهاند) و سپس جستجوی برداری را در میان نتایج محدود شده انجام دهد. این رویکرد که به آن Hybrid Search نیز گفته میشود، هم سرعت و هم دقت جستجو را به شدت افزایش میدهد.
5. لایه بازیابی: هنر پیدا کردن سوزن در انبار کاه (Retrieval)
هنگامی که کاربر سؤالی میپرسد، سؤال او به بردار تبدیل شده و به دیتابیس برداری ارسال میشود. در این مرحله، الگوریتمهای جستجو وارد عمل میشوند تا نزدیکترین بردارها را به بردار سؤال پیدا کنند. متداولترین روشها برای اندازهگیری شباهت بین بردارها عبارتند از Cosine Similarity، Dot Product و Euclidean Distance. روش Cosine Similarity به دلیل استقلال از طول بردارها، در بیشتر سیستمهای RAG مورد استفاده قرار میگیرد.
اما بازیابی تنها پیدا کردن نزدیکترین بردارها نیست. یکی از مشکلات رایج این است که متنی که از نظر معنایی بسیار به سؤال شبیه است، ممکن است حاوی پاسخ دقیق نباشد. برای حل این مشکل، تکنیکهای پیشرفته بازیابی توسعه یافتهاند. یکی از این تکنیکها Multi-Query Retrieval است که در آن، سؤال کاربر توسط مدل زبانی به چند سؤال مشابه بازنویسی میشود و جستجو برای تمام آنها انجام میگیرد تا شانس پیدا شدن اطلاعات دقیق افزایش یابد.
تکنیک دیگر Re-ranking (رتبهبندی مجدد) است. در این روش، ابتدا تعداد زیادی سند (مثلاً 50 قطعه برتر) بازیابی میشوند. سپس یک مدل تخصصی (مانند مدلهای Cross-Encoder) این 50 قطعه را با دقت بسیار بالاتری بررسی و امتیازدهی میکند و بهترین آنها (مثلاً 5 قطعه برتر) را برای ارسال به مرحله بعدی انتخاب مینماید. استفاده ترکیبی از جستجوی کلمه کلیدی سنتی (مانند BM25) و جستجوی برداری، که به آن جستجوی هیبریدی میگویند، از دیگر رویکردهای موفق در لایه بازیابی است.
6. لایه تولید پاسخ: آشپزی نهایی با مواد بازیابی شده (Generation)
مرحله نهایی معماری RAG، لایه تولید پاسخ است. در این لایه، متون بازیابی شده به عنوان مواد اولیه، همراه با سؤال کاربر به یک مدل زبانی قدرتمند (مانند GPT-4 یا Llama 3) داده میشوند تا پاسخ نهایی را آماده کند. در اینجا، نحوه نگارش پرامپت (Prompt Engineering) نقش حیاتی ایفا میکند. پرامپت باید به گونهای طراحی شود که مدل زبانی را محدود به استفاده از اطلاعات ارائه شده کند تا از بروز پدیده توهم جلوگیری شود.
یک پرامپت استاندارد در سیستم RAG معمولاً ساختاری مشابه این دارد: «با استفاده از متون پسزمینه زیر، به سؤال پاسخ بده. اگر پاسخ در متون زیر وجود ندارد، بگو که نمیدانم و از اطلاعات قبلی خودت استفاده نکن.» این دستورالعمل ساده، تفاوت بین یک سیستم قابل اعتماد و یک سیستم دروغپرداز را تعیین میکند. همچنین در این مرحله میتوان پارامترهای مدل زبانی را تنظیم کرد. برای کسب اطلاعات بیشتر درباره تنظیمات مدل، میتوانید به مقاله دمای مدل، Top-P و Top-K مراجعه کنید.
علاوه بر دقت محتوا، مدل زبانی باید بتواند اطلاعات را به صورت ساختاریافته، روان و خوانا ارائه دهد. میتواند ارجاعات و نقل قولها را به متن اصلی اضافه کند تا کاربر بتواند منبع هر بخش از پاسخ را بررسی کند. این شفافیت، اعتماد کاربران به سیستم RAG را به شدت افزایش میدهد. در برخی از سیستمهای پیشرفته، حتی قبل از نمایش پاسخ به کاربر، یک بررسیکننده (Evaluator) ثانویه پاسخ را با اسناد اولیه مقایسه میکند تا از صحت کامل آن اطمینان حاصل شود.
7. کلام پایانی: معماری، ستون نامرئی کیفیت
معماری RAG چیزی فراتر از چسباندن یک موتور جستجو به یک مدل زبانی است. این معماری، یک سیستم یکپارچه و به هم پیوسته است که در آن، عملکرد هر لایه بر لایههای دیگر تأثیر مستقیم میگذارد. تکهبندی ضعیف منجر به بازیابی اطلاعات ناقص میشود و بازیابی نامناسب باعث میشود مدل زبانی پاسخی بیکیفیت یا نامربوط تولید کند. موفقیت در پیادهسازی RAG نیازمند شناخت دقیق دادهها، انتخاب ابزارهای مناسب و تنظیمات مکرر (Tuning) است.
همانطور که هوش مصنوعی با سرعت در حال پیشرفت است، معماریهای RAG نیز پیچیدهتر و کارآمدتر میشوند. مفاهیمی مانند Graph RAG که از گرافهای دانش برای بهبود جستجو استفاده میکند، و Agentic RAG که در آن مدل زبانی خودش تصمیم میگیرد چه زمانی و چگونه جستجو کند، در حال تبدیل شدن به استانداردهای جدید هستند. با این حال، اصول اولیهای که در این مقاله بررسی کردیم – از Chunking تا Embedding، Vector DB، Retrieval و Generation – همواره هسته اصلی این سیستمها باقی خواهند ماند.
با درک عمیق این لایهها، شما نه تنها میتوانید سیستمهای کارآمدتری طراحی کنید، بلکه میتوانید مشکلات و خطاهای سیستم را بسیار سریعتر شناسایی و رفع نمایید. معماری قدرتمند، ستون نامرئی است که سیستم هوش مصنوعی شما را به یک دستیار هوشمند، قابل اعتماد و بینظیر تبدیل میکند.
8. چالشهای مقیاسپذیری و بهینهسازی در سیستمهای RAG
وقتی که سیستم RAG خود را از فاز آزمایشگاهی (Proof of Concept) به محیط عملیاتی (Production) منتقل میکنید، چالشهای کاملاً جدیدی ظهور میکنند. مقیاسپذیری یکی از مهمترین این چالشها است. فرض کنید به جای هزار سند، حالا باید میلیونها سند را پردازش، بردارسازی و جستجو کنید. در این مقیاس، زمان پردازش و هزینههای مربوط به APIهای بردارسازی به شدت افزایش مییابد. راهکار اصلی در اینجا، استفاده از سیستمهای صفبندی (مانند RabbitMQ یا Kafka) و پردازش ناهمگام (Asynchronous) است تا سیستم زیر بار سنگین دچار اختلال نشود.
بهینهسازی پایگاه داده برداری (Vector DB Optimization) نیز حیاتی است. استفاده از ایندکسهای تقریبی (Approximate Nearest Neighbor - ANN) مانند HNSW (Hierarchical Navigable Small World) به جای جستجوی دقیق، میتواند سرعت بازیابی را تا صدها برابر افزایش دهد، در حالی که افت دقت بسیار ناچیزی به همراه دارد. همچنین استفاده از تکنیکهای فشردهسازی بردارها (مانند Quantization) میتواند مصرف حافظه RAM را به میزان قابل توجهی کاهش داده و هزینههای زیرساخت را پایین بیاورد.
از سوی دیگر، مسئله همگامسازی دادهها (Data Synchronization) مطرح میشود. اسناد منبع ممکن است روزانه تغییر کنند، حذف شوند یا اسناد جدیدی اضافه گردند. سیستم RAG باید قادر باشد به سرعت و با کمترین هزینه، پایگاه داده برداری خود را با منابع اصلی همگام کند. این کار نیازمند پیادهسازی مکانیزمهای دقیق پیگیری تغییرات (Change Data Capture) و آپدیتهای افزایشی (Incremental Updates) است، تا نیازی به بردارسازی مجدد تمام اسناد نباشد و فقط بخشهای تغییر یافته بروزرسانی شوند.
9. روشهای ارزیابی و سنجش عملکرد RAG
چگونه میتوان فهمید که سیستم RAG ما خوب کار میکند؟ ارزیابی سیستمهای تولیدی بسیار دشوارتر از سیستمهای دستهبندی کلاسیک است. یک پاسخ میتواند از نظر نگارشی کاملاً درست باشد اما اطلاعات غلطی را ارائه دهد یا اطلاعات کلیدی سند را جا بیندازد. چارچوبهای ارزیابی پیشرفتهای مانند RAGAS (RAG Assessment) و TruLens توسعه یافتهاند تا عملکرد سیستم را از زوایای مختلف بررسی کنند و امتیازات کمی و دقیقی ارائه دهند.
اولین معیار مهم، وفاداری (Faithfulness) است. این معیار بررسی میکند که پاسخ تولید شده تا چه حد فقط به متون بازیابی شده متکی است و از اطلاعات خارجی یا توهمات مدل استفاده نکرده است. معیار دوم، مرتبط بودن پاسخ (Answer Relevance) است که میزان همخوانی پاسخ با سؤال کاربر را میسنجد. پاسخی ممکن است کاملاً بر اساس متون باشد اما به سؤال کاربر ربطی نداشته باشد. معیار سوم، مرتبط بودن زمینه (Context Relevance) است که کیفیت عملکرد لایه بازیابی را ارزیابی میکند. آیا اسنادی که بازیابی شدهاند، واقعاً حاوی اطلاعات لازم برای پاسخگویی به سؤال هستند؟
ارزیابی مستمر (Continuous Evaluation) یکی از بهترین شیوهها برای حفظ کیفیت سیستم در طول زمان است. با ذخیره کردن سؤالات کاربران و پاسخهای تولید شده (Log Analytics)، میتوان با استفاده از یک مدل زبانی قویتر (مانند GPT-4) به عنوان ارزیاب (LLM-as-a-Judge)، عملکرد سیستم را در طول زمان نظارت کرد. این فیدبک لوپ (Feedback Loop) به توسعهدهندگان اجازه میدهد تا نقاط ضعف سیستم، چه در بخش تکهبندی، چه در بردارسازی و چه در تولید نهایی را به سرعت شناسایی و رفع نمایند.
10. آینده معماری RAG: فراتر از جستجوی ساده
آینده سیستمهای RAG بسیار هیجانانگیز است. در حال حاضر، تمرکز اصلی بر روی متن است، اما سیستمهای RAG چندرسانهای (Multimodal RAG) در حال ظهور هستند. تصور کنید کاربری سؤالی میپرسد و سیستم علاوه بر متن، نمودارها، تصاویر و حتی ویدیوهای مرتبط را بازیابی و ترکیب میکند. با پیشرفت مدلهای بینایی ماشین (Vision Models)، این رویا به زودی به یک واقعیت روزمره تبدیل خواهد شد.
همچنین، ترکیب RAG با مفاهیم یادگیری تقویتی (Reinforcement Learning) مرزهای جدیدی را باز کرده است. مدلها میتوانند یاد بگیرند که چه زمانی نیاز به جستجوی اطلاعات دارند و چه زمانی دانش داخلی آنها کافی است (Active RAG). آنها حتی میتوانند یاد بگیرند که در صورت نیافتن پاسخ در جستجوی اول، استراتژی جستجوی خود را تغییر داده و سؤالات متفاوتی را در دیتابیس مطرح کنند، که این موضوع باعث افزایش چشمگیر استقلال و هوشمندی سیستم میشود.
در نهایت، باید تأکید کرد که معماری RAG صرفاً یک تکنولوژی گذرا نیست؛ بلکه یک الگو و پارادایم اساسی در نحوه تعامل ما با حجم عظیم اطلاعات است. با تسلط بر اجزا و مفاهیم پایهای مانند Chunking، Embedding و Retrieval، شما نه تنها آماده ساخت سیستمهای کارآمد امروزی هستید، بلکه پایه و اساس محکمی برای پیادهسازی و درک نوآوریهای آینده در دنیای هوش مصنوعی خواهید داشت. سرمایهگذاری روی درک عمیق این معماری، یکی از ارزشمندترین کارهایی است که یک مهندس یا محقق هوش مصنوعی میتواند امروز انجام دهد.
در پایان، یادآور میشویم که مفاهیمی چون پنجره زمینه محدود و خطرات ناشی از پدیده توهم در مدلهای زبانی، استفاده از معماری قدرتمند RAG را از یک انتخاب جذاب به یک ضرورت قطعی برای کاربردهای حساس و تجاری تبدیل کردهاند. با تنظیم دقیق دمای مدل و پارامترهای تولید پاسخ، میتوانید به ترکیبی بینظیر از دقت، خلاقیت و قابلیت اطمینان دست یابید و تجربه کاربری بینقصی را خلق کنید.
11. تاثیر و اهمیت پیشپردازش دادهها در RAG
موفقیت یک معماری RAG، فارغ از کیفیت مدلهای زبانی و ابزارهای مورد استفاده، وابستگی مستقیمی به کیفیت دادههای ورودی دارد. پیشپردازش دادهها (Data Preprocessing) شاید کمهیجانترین بخش کار به نظر برسد، اما بدون شک یکی از سرنوشتسازترین مراحل است. دادههای متنی خام اغلب حاوی نویزهای فراوانی هستند؛ از تگهای HTML و کاراکترهای نامربوط گرفته تا سرصفحهها، پاصفحهها و متون تکراری که هیچ ارزش معنایی ندارند. اگر این نویزها پاکسازی نشوند، مستقیماً وارد دیتابیس برداری شده و باعث کاهش شدید دقت بازیابی خواهند شد.
فرآیند پیشپردازش شامل مراحلی چون نرمالسازی متن (Text Normalization)، حذف کاراکترهای ویژه، اصلاح فاصلهگذاریها و یکپارچهسازی فرمتها است. در زبان فارسی، این مرحله از حساسیت مضاعفی برخوردار است. مسائلی مانند تفاوت بین ی و ک عربی و فارسی، فاصلههای مجازی (نیمفاصله) و تنوع در نگارش کلمات (مانند کتابها در مقابل کتاب ها)، میتوانند باعث شوند که سیستم در مرحله بردارسازی دچار خطای محاسباتی شده و متون مشابه را به اشتباه از یکدیگر دور فرض کند. استفاده از ابزارهای پردازش زبان طبیعی فارسی مانند حذفیات و ریشهیابها، در این مرحله به شدت توصیه میشود.
علاوه بر پاکسازی، غنیسازی دادهها (Data Enrichment) نیز بخشی از این فرآیند است. در این مرحله میتوانیم اطلاعات ساختاریافتهای را به متون اضافه کنیم تا در مرحله بازیابی به سیستم کمک کنند. استخراج کلمات کلیدی، شناسایی موجودیتهای نامدار (NER) و خلاصهسازی هوشمندانه از جمله تکنیکهای غنیسازی هستند که به دیتابیس برداری اجازه میدهند علاوه بر معنای کلی متن، بر روی کلمات کلیدی و مفاهیم خاص نیز حساسیت بیشتری نشان دهند. این ترکیب ظریف از پاکسازی و غنیسازی، شالوده اصلی یک سیستم RAG قدرتمند را بنا میکند.
12. مقایسه رویکرد RAG با Fine-Tuning: کدام یک بهتر است؟
یکی از سؤالات متداولی که توسعهدهندگان هوش مصنوعی با آن مواجه میشوند، انتخاب بین معماری RAG و روش Fine-Tuning (تنظیم دقیق) است. برای پاسخ به این سؤال، باید تفاوتهای بنیادین این دو رویکرد را درک کنیم. فرآیند Fine-Tuning شامل آموزش مجدد مدل با استفاده از مجموعه دادههای خاص است تا مدل الگوها، لحن و دانش جدید را در ساختار پارامترهای خود نهادینه کند. این فرآیند بسیار پرهزینه و زمانبر است و هر بار که اطلاعات جدیدی اضافه میشود، نیاز به آموزش مجدد دارد.
در نقطه مقابل، معماری RAG نیازی به تغییر در پارامترهای مدل اصلی ندارد. این معماری، اطلاعات را از طریق یک منبع خارجی (دیتابیس برداری) به صورت لحظهای و پویا (Dynamic) در اختیار مدل قرار میدهد. بزرگترین مزیت RAG، قابلیت بهروزرسانی آسان و سریع دادهها است. اگر یک قانون جدید تصویب شود یا مشخصات یک محصول تغییر کند، تنها کافی است متون مربوطه در دیتابیس برداری آپدیت شوند و مدل بلافاصله به اطلاعات جدید دسترسی خواهد داشت. همچنین، در RAG همواره منبع دقیق هر اطلاعات مشخص است، قابلیتی که در مدلهای Fine-tune شده وجود ندارد.
با این حال، این دو رویکرد لزوماً در تقابل با یکدیگر نیستند. در سیستمهای بسیار پیشرفته و مقیاسپذیر، از ترکیب هر دو روش استفاده میشود. به عنوان مثال، یک مدل پایه با استفاده از دادههای اختصاصی یک شرکت Fine-tune میشود تا لحن برند، اصطلاحات تخصصی سازمان و نحوه پاسخگویی ایدهآل را بیاموزد و سپس، همین مدل به یک معماری RAG متصل میشود تا برای پاسخ به سؤالات روزمره به مستندات آنلاین و پایگاه داده سازمانی مراجعه کند. این رویکرد هیبریدی، ترکیبی از بهترین قابلیتهای هر دو روش را به ارمغان میآورد و سیستمی بیرقیب از نظر دقت، امنیت و سرعت را میسازد.
13. معماری RAG پیشرفته: یکپارچهسازی گرافهای دانش (Knowledge Graphs)
با افزایش پیچیدگی وظایف محول شده به سیستمهای هوش مصنوعی، اتکای صرف به دیتابیسهای برداری (Vector Databases) گاهی اوقات پاسخگوی نیازهای پیچیده نیست. دیتابیسهای برداری در یافتن قطعات متنی که از نظر معنایی مشابه پرسش هستند، عالی عمل میکنند، اما در درک روابط پیچیده بین موجودیتهای مختلف (Entities) ضعف دارند. اینجا است که گرافهای دانش (Knowledge Graphs) وارد معماری RAG میشوند و پارادایم جدیدی به نام Graph RAG را شکل میدهند. گرافهای دانش، اطلاعات را به صورت شبکهای از موجودیتها و روابط بین آنها (مانند "اپل" -> "سازنده" -> "آیفون") مدلسازی میکنند.
ترکیب گراف دانش با RAG به سیستم اجازه میدهد تا به پرسشهایی پاسخ دهد که نیازمند استدلال چندمرحلهای (Multi-hop Reasoning) هستند. به عنوان مثال، اگر کاربر بپرسد "مدیرعامل شرکتی که نرمافزار CRM ایکس را در سال ۲۰۲۳ خرید کیست؟"، یک سیستم RAG سنتی ممکن است در یافتن تمام این ارتباطات پراکنده در اسناد مختلف شکست بخورد. اما Graph RAG با پیمایش در گراف دانش، به راحتی این مسیر را طی کرده و پاسخ دقیق را استخراج میکند. این معماری پیشرفته، دقت را به سطح بیسابقهای ارتقا میدهد و به ویژه در حوزههای تخصصی مانند پزشکی، حقوق و امور مالی که روابط بین دادهها بسیار حیاتی است، کاربردهای فراوانی دارد.
پیادهسازی Graph RAG نیازمند یک مرحله پیشپردازش مضاعف است؛ استخراج موجودیتها و روابط از متون خام و ساختن گراف دانش پیش از مرحله بردارسازی. ابزارهایی مانند LlamaIndex و LangChain اخیراً پشتیبانی گستردهای از این قابلیتها اضافه کردهاند و پایگاههای داده گرافی مانند Neo4j نیز با افزودن قابلیتهای جستجوی برداری، بستر مناسبی برای این معماری ترکیبی فراهم نمودهاند. هرچند پیچیدگی توسعه در این روش بالاتر است، اما خروجی نهایی، سیستمی هوشمندتر، قابل فهمتر و با قابلیت استدلال بسیار قویتر خواهد بود.
14. نقش Prompt Engineering و Context Window در RAG
همانطور که در لایه تولید پاسخ (Generation) اشاره شد، نحوه ارتباط با مدل زبانی تأثیر بسزایی در کیفیت نهایی پاسخ سیستم RAG دارد. مهندسی پرامپت (Prompt Engineering) فراتر از یک دستورالعمل ساده، یک هنر و علم ترکیب متن کاربر با اطلاعات بازیابی شده است. یک پرامپت خوب باید نه تنها اطلاعات را ارائه دهد، بلکه باید قالب، لحن و محدودیتهای مدل را به دقت مشخص کند. استفاده از تکنیکهایی مانند Few-Shot Prompting، که در آن چند نمونه از پرسش و پاسخ مطلوب به مدل داده میشود، میتواند عملکرد لایه نهایی را به میزان قابل توجهی پایدارتر کند.
مسئله مهم دیگر، مدیریت پنجره زمینه (Context Window) است. با اینکه مدلهای جدید مانند GPT-4 و Claude 3 دارای پنجره زمینه بسیار بزرگی (تا میلیونها توکن) هستند، اما ارسال تمام اطلاعات بازیابی شده به مدل همیشه بهترین کار نیست. مدلهای زبانی در پدیدهای به نام "گمشده در میانه" (Lost in the Middle) ممکن است اطلاعات مهمی که در میانه متون طولانی قرار دارند را نادیده بگیرند. بنابراین، انتخاب دقیقترین و خلاصهترین قطعات متنی و ارائه ساختاریافته آنها به مدل، بسیار کارآمدتر از ارسال حجم انبوهی از متون است.
بهعلاوه، هرچه پنجره زمینه بیشتری استفاده شود، هزینه استفاده از API مدل زبانی افزایش یافته و زمان پاسخگویی (Latency) نیز بیشتر میشود. بنابراین، معماری RAG بهینهسازی شده باید تعادل دقیقی بین میزان اطلاعات ارائهشده و هزینهها برقرار کند. تکنیکهایی مانند فشردهسازی زمینه (Context Compression) و خلاصهسازی اسناد پیش از ارسال به مدل نهایی، از راهکارهای مؤثر برای مدیریت هوشمندانه پنجره زمینه در سیستمهای RAG محسوب میشوند.
15. جمعبندی جامع و چشمانداز تکاملی سیستمهای RAG
در طول این مقاله مفصل، ما از ابتداییترین لایههای معماری RAG آغاز کردیم و تا پیشرفتهترین مفاهیم و چالشهای عملیاتی پیش رفتیم. از تکهبندی هوشمندانه اسناد در مرحله Chunking، تا تبدیل معانی به اعداد در لایه Embedding، و از ذخیرهسازی در دیتابیسهای برداری پیشرفته تا تکنیکهای پیچیده Retrieval و در نهایت، تولید پاسخی دقیق و قابل استناد. معماری RAG نمایانگر یک بلوغ واقعی در زمینه هوش مصنوعی کاربردی است؛ جایی که توهمات مدل جای خود را به دانش مستند میدهند.
چشمانداز آینده نشان میدهد که سیستمهای RAG نه تنها به تکامل خود ادامه خواهند داد، بلکه به استانداردی پیشفرض برای هر اپلیکیشن سازمانی مبتنی بر LLM تبدیل خواهند شد. ادغام قابلیتهای چندرسانهای (Multimodal)، استفاده از گرافهای دانش (Graph RAG) و ظهور عاملهای هوشمند (Agentic RAG) که به صورت خودمختار استراتژیهای جستجوی خود را تنظیم میکنند، گامهای بعدی در این مسیر پرشتاب هستند.
برای توسعهدهندگان و معماران نرمافزار، تسلط بر اکوسیستم RAG دیگر یک مهارت جانبی نیست، بلکه یک ضرورت حیاتی است. ابزارها و فریمورکها ممکن است تغییر کنند، دیتابیسهای جدیدی معرفی شوند و مدلهای زبانی قدرتمندتری پا به عرصه بگذارند، اما اصول مهندسی داده، درک عمیق از جستجوی معنایی و طراحی معماری مقیاسپذیر، همواره ارزشمند باقی خواهند ماند. با ساختن یک سیستم RAG قدرتمند، شما نه تنها هوش مصنوعی را به کسبوکار خود میآورید، بلکه دانشی قابل اعتماد، سریع و بیمرز را در اختیار کاربران خود قرار میدهید.