کتابخانهدار دیجیتال: تصور کنید مدل زبانی یک کتابخانهدار بدون کتابخانه است
یکی از بهترین راهها برای درک عمیق مفهوم RAG (Retrieval-Augmented Generation) یا «تولید تقویتشده با بازیابی»، استفاده از یک استعاره ساده اما بسیار دقیق است. تصور کنید شما به یکی از باهوشترین، باسوادترین و خوشبیانترین کتابخانهدارهای جهان دسترسی دارید. این کتابخانهدار فوقالعاده تمام کتابهای عمومی چاپ شده تا سال خاصی را با دقت خوانده است و حافظه بینظیری برای به یاد آوردن مفاهیم کلی، الگوهای زبانی پیچیده و حقایق تاریخی دارد. او میتواند با شما درباره نظریه ریسمان در فیزیک کوانتوم، جزئیات جنگهای پونیک در تاریخ روم باستان، یا ساختار یک غزل از دیوان حافظ با فصاحت تمام و برای ساعتها صحبت کند. این کتابخانهدار در دنیای ما نماد یک مدل زبانی بزرگ (Large Language Model یا LLM) مانند GPT-4 از OpenAI، کلود از Anthropic، یا جمینای از گوگل است. آنها با بلعیدن بخش عظیمی از اینترنت، دانش شگرفی در وزنهای خود اندوختهاند.
اما یک مشکل بسیار بزرگ و بنیادی وجود دارد: این کتابخانهدار دانشمند در یک اتاق کاملا خالی نشسته است. هیچ کتابخانهای در کار نیست، هیچ قفسهای وجود ندارد، هیچ سیستم جستجویی در دسترس نیست و هیچ سند جدیدی پس از ورود او به این اتاق وارد نشده است. اگر از او درباره اتفاقاتی که همین دیروز در اخبار فناوری یا سیاست رخ داده بپرسید، یا اگر بخواهید اطلاعات دقیقی از یک سند محرمانه داخلی شرکت خودتان، گزارشهای مالی سه ماهه اخیر، یا پرونده پزشکی یک بیمار خاص به شما بدهد، او چه کار میتواند بکند؟ او نمیتواند به قفسهها مراجعه کند چون هیچ قفسهای وجود ندارد. در این حالت، او یا با صداقت و مودبانه اعتراف میکند که اطلاعاتی در این زمینه ندارد، یا بدتر از آن، با استفاده از توانایی داستانسرایی قدرتمند و حدس و گمان آماری خود، سعی میکند پاسخی منطقی اما کاملا ساختگی به شما تحویل دهد. او کلماتی را کنار هم میچیند که در ظاهر کاملا درست به نظر میرسند، اما در باطن هیچ پایه و اساس واقعی ندارند. این دقیقا همان پدیده توهم در LLMها است که یکی از بزرگترین چالشهای استفاده از هوش مصنوعی مولد در محیطهای سازمانی، پزشکی، حقوقی و حساس به شمار میرود. توهم (Hallucination) زمانی رخ میدهد که مدل زبانی با اعتماد به نفس کامل دروغ میگوید.
اینجا دقیقا همان جایی است که معماری انقلابی RAG وارد میدان میشود و قواعد بازی را تغییر میدهد. رویکرد RAG به جای اینکه این کتابخانهدار را مجبور کند همهچیز را تا ابد حفظ کند و برای یادگیری هر موضوع جدیدی نیازمند آموزش مجدد (که بسیار پرهزینه است) باشد، یک کتابخانه عظیم، سازمانیافته، دیجیتال و کاملا بهروز را دقیقا در کنار اتاق او میسازد و به او ابزاری پیشرفته میدهد تا قبل از پاسخ دادن به هر سوال شما، ابتدا در این کتابخانه جستجو کند. با پیادهسازی RAG، وقتی شما سوالی میپرسید، ابتدا یک دستیار جستجوگر (سیستم بازیابی اطلاعات) وارد عمل میشود. او میرود و دقیقترین، مرتبطترین و مستندترین اسناد را از میان میلیونها سند موجود در قفسههای این کتابخانه اختصاصی پیدا میکند، آنها را مستقیما روی میز کتابخانهدار میگذارد و به او دستور میدهد: «لطفا با توجه دقیق به این متنهایی که برایت پیدا کردم، به سوال این کاربر پاسخ بده و از خودت چیزی اختراع نکن.»
به این ترتیب، مدل زبانی دیگر نیازی ندارد که تمام اطلاعات دنیا یا دادههای خصوصی کسبوکار شما را به سختی در وزنهای عصبی (Neural Weights) خود ذخیره کند. او صرفا از مهارتهای استدلال، ترکیب، خلاصهسازی و درک مطلب فوقالعاده خود برای تفسیر اسنادی که به او داده شده استفاده میکند. این تغییر پارادایم بینظیر، هوش مصنوعی را از یک «دانای کل مستعد توهم و دروغ» به یک «تحلیلگر دقیق، محتاط و کاملا مستند» تبدیل میکند که ارزش افزوده فوقالعادهای برای کسبوکارها به ارمغان میآورد. RAG به ما اجازه میدهد تا دانش نامحدود و در حال تغییر را با قدرت پردازش زبان طبیعی پیوند بزنیم.
معماری سهلایه RAG: بازیابی، تقویت، تولید
سیستم RAG در هسته خود و از نظر معماری نرمافزاری، از سه مرحله یا لایه اصلی تشکیل شده است که هر کدام از این لایهها نقش حیاتی در کیفیت پاسخ نهایی ایفا میکنند و نقص در هر یک میتواند کل سیستم را دچار مشکل کند. نام RAG دقیقا از همین سه مرحله گرفته شده است: Retrieval (بازیابی)، Augmented (تقویتیافته) و Generation (تولید). بیایید هر یک از این مراحل سهگانه را زیر ذرهبین ببریم و ببینیم دقیقا چه اتفاقی در سطح سیستمی میافتد.
۱. بازیابی (Retrieval)
مرحله بازیابی را میتوان قلب تپنده و شاید مهمترین و چالشبرانگیزترین بخش یک سیستم RAG دانست. وظیفه اصلی و خطیر این لایه آن است که از میان صدها هزار یا شاید میلیونها سند، پاراگراف و خط کد موجود در پایگاه داده دانش شما، دقیقا آنهایی را که بیشترین ارتباط معنایی و مفهومی را با درخواست یا پرسش کاربر دارند، پیدا کرده و استخراج کند. بر خلاف جستجوی سنتی و قدیمی مبتنی بر کلمات کلیدی (Keyword-based Search یا Lexical Search) که در موتورهای جستجوی کلاسیک مانند نسخههای اولیه Elasticsearch استفاده میشد، سیستمهای بازیابی در RAG مدرن از جستجوی معنایی (Semantic Search) قدرت میگیرند. در جستجوی کلمات کلیدی، اگر شما از سیستم بپرسید «قوانین مربوط به مرخصی زایمان در شرکت چیست؟»، سیستم فقط به دنبال اسنادی میگردد که عینا کلمات «مرخصی» و «زایمان» در آنها تکرار شده باشد. اگر سند شما از کلمات مترادف استفاده کرده باشد، سیستم سنتی آن را پیدا نمیکند. اما در جستجوی معنایی، سیستم با استفاده از هوش مصنوعی درک میکند که مفهوم پنهان در پشت این کلمات چیست و حتی اگر در یک سند رسمی نوشته شده باشد «مقررات استراحت پزشکی پس از تولد فرزند برای پرسنل»، آن را نیز با دقت بالا به عنوان یک نتیجه کاملا مرتبط بازیابی میکند.
۲. تقویت (Augmentation)
مرحله تقویت، پل ارتباطی حیاتی و هوشمندانهای است بین سیستم بازیابی اطلاعات (که اسناد را پیدا کرده) و مدل زبانی بزرگ (که قرار است پاسخ را تولید کند). در این مرحله مهندسی شده، پرسش اولیه کاربر با اطلاعات ناب استخراج شده از مرحله قبل ترکیب میشود تا یک دستور یا پرامپت (Prompt) غنی، جامع و محدودکننده ساخته شود. تصور کنید کاربر در چتبات سازمانی پرسیده است: «سیاست دورکاری شرکت ما در روزهای برفی چیست؟» سیستم بازیابی، دو پاراگراف مرتبط را از کتابچه راهنمای کارمندان پیدا کرده است. در مرحله تقویت، ما در بکاند سیستم یک متن بزرگتر و ساختاریافته به این شکل میسازیم: «شما یک دستیار هوش مصنوعی دقیق و وفادار به متن هستید. لطفا به سوال کاربر در انتهای این پرامپت، فقط و فقط بر اساس اطلاعات ارائه شده در ادامه پاسخ دهید. اگر پاسخ در اطلاعات نبود، صراحتا بگو که اطلاعات کافی در دسترست نیست و حدس نزن. اطلاعات استخراج شده: [پاراگراف ۱: در روزهای برفی کارمندان میتوانند با هماهنگی مدیر از خانه کار کنند.] [پاراگراف ۲: دورکاری در این روزها نیازمند ثبت در پورتال است]. سوال کاربر: سیاست دورکاری شرکت ما در روزهای برفی چیست؟» این فرآیند تزریق اطلاعات بازیابیشده به درخواست کاربر را Prompt Augmentation مینامند. این مرحله به شدت به محدودیتهای فیزیکی مدل از جمله پارامتر، توکن و پنجره زمینه وابسته است، زیرا هر مدل زبانی مقدار محدودی متن (Context Window) را میتواند در یک لحظه به عنوان ورودی پردازش کند. مدیریت هوشمندانه این توکنها هنر مهندس سیستم است.
۳. تولید (Generation)
پس از اینکه پرامپت تقویتشده و غنی آماده شد، در نهایت به مدل زبانی بزرگ (LLM) ارسال میگردد. در این مرحله نهایی، مدل زبانی از دانش از پیشآموخته خود تنها برای ساختاربندی پاسخ، رعایت دستور زبان صحیح، درک لحن مناسب و خلاصهسازی استفاده میکند، اما محتوای واقعی و فکتهای پاسخ خود را اکیدا محدود به اطلاعات اضافهشده در پرامپت میسازد. مدل مانند یک تحلیلگر انسانی، اسناد را با دقت میخواند، بخشهای مرتبط با سوال را در ذهن خود ترکیب میکند و یک پاسخ روان، طبیعی، خوشخوان و کاملا مستند به کاربر ارائه میدهد. نتیجه نهایی، متنی است که هم کیفیت نگارشی و روانی شگفتانگیز هوش مصنوعی را در خود دارد و هم دقت، صحت و اعتبار دادههای اختصاصی سازمان شما را. این ترکیب رویایی، کاربر را از جستجوهای خستهکننده در میان دهها فایل پیدیاف بینیاز میکند.
از متن تا بردار: سفر یک سند درون خط لوله RAG
برای اینکه جستجوی معنایی جادویی در مرحله بازیابی اصلا امکانپذیر باشد، ما نمیتوانیم متنها را به همان شکل خام و رشتهای از حروف ذخیره کنیم. کامپیوترها در پایینترین سطح خود کلمات، احساسات و مفاهیم را درک نمیکنند؛ آنها فقط و فقط با اعداد و ماتریسها سر و کار دارند. در اینجا پای یکی از مهمترین، پیچیدهترین و در عین حال جذابترین مفاهیم هوش مصنوعی مدرن، یعنی Embedding ها یا «تعبیههای برداری» به میان میآید. امبدینگها راز اصلی موفقیت شبکههای عصبی در پردازش زبان طبیعی هستند.
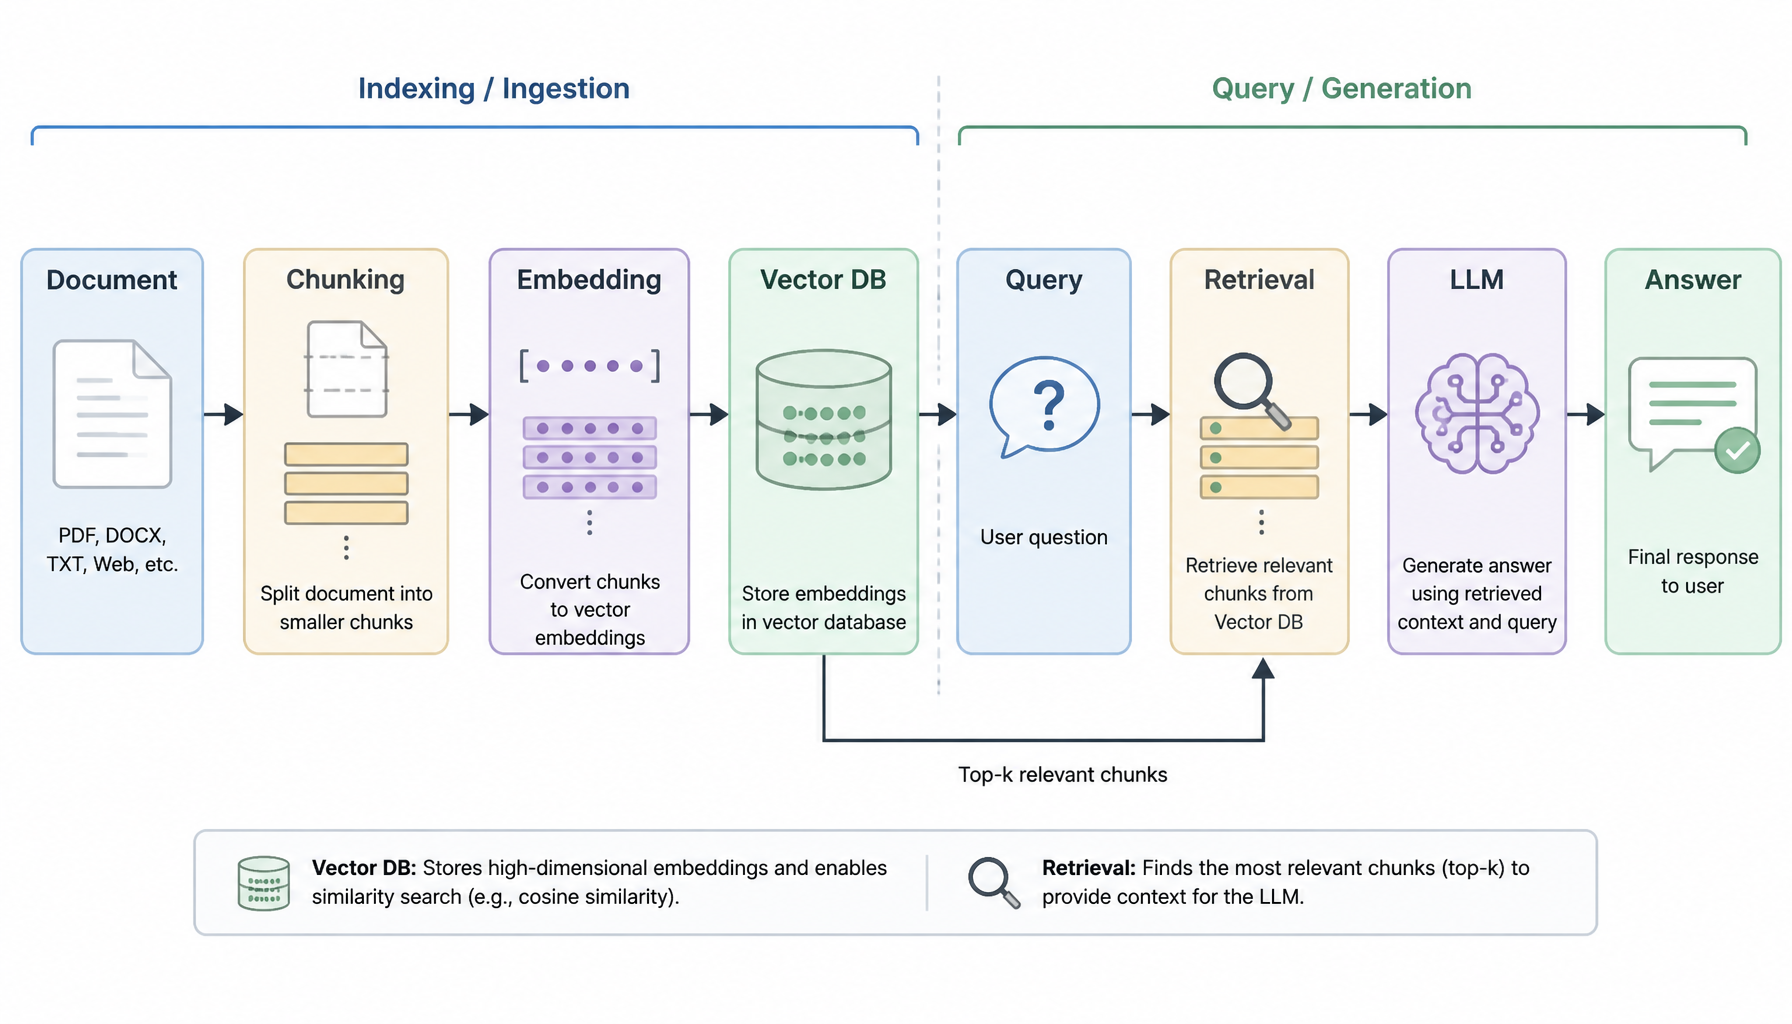
سفر یک سند متنی در خط لوله پردازش داده سیستم RAG (Data Ingestion Pipeline) شامل چندین مرحله پردازشی پیچیده است که در ادامه آنها را به صورت مفصل و با جزئیات فنی بررسی میکنیم:
استخراج و پاکسازی اولیه (Extraction & Cleaning)
ابتدا، دادههای سازمان شما باید از منابع مختلف استخراج شوند. این منابع میتوانند بسیار متنوع باشند: صدها فایل PDF، هزاران صفحه وب، پایگاههای داده رابطهای SQL، فایلهای متنی ساده، ایمیلها، اسناد Word یا حتی زیرنویس ویدیوهای آموزشی. متن خام از این منابع استخراج شده و به شدت پاکسازی میشود. تگهای HTML اضافی، کاراکترهای نامربوط، فاصلههای خالی بیش از حد و متادیتای غیرمفید پاک میشوند تا یک متن خالص، تمیز و قابل پردازش برای ماشین به دست آید. کیفیت دادهها در این مرحله مستقیما بر کیفیت پاسخ نهایی سیستم تاثیر میگذارد (قانون زباله ورودی، زباله خروجی).
بخشبندی هوشمند متون (Chunking)
یکی از مفاهیم حیاتی و بسیار ظریف در مهندسی RAG، چانکینگ یا بخشبندی متون است. ما قطعا نمیتوانیم یک کتاب ۵۰۰ صفحهای را به صورت یکجا تبدیل به یک بردار کنیم یا آن را درون پرامپت مدل زبانی قرار دهیم، زیرا از یک سو مدلها دارای محدودیت سختافزاری به نام پنجره زمینه (Context Window) هستند و از سوی دیگر پردازش متون بسیار طولانی به شدت گرانقیمت، کند و ناکارآمد است. همچنین اگر یک بردار نمایانگر کل یک کتاب باشد، مفهوم آن آنقدر کلی میشود که در جستجوی معنایی سوالات جزئی به کار نمیآید. بنابراین، ما اسناد بلند را به قطعات کوچکتری به نام Chunk تقسیم میکنیم. استراتژیهای بسیار متنوعی برای چانکینگ وجود دارد که انتخاب هر کدام به نوع دادههای شما بستگی دارد:
- بخشبندی با طول ثابت (Fixed-size Chunking): در این روش که سادهترین نوع است، متن به صورت مکانیکی به قطعاتی با تعداد کاراکتر یا توکن ثابت (مثلا هر ۵۰۰ توکن یا ۱۰۰۰ کاراکتر) تقسیم میشود. این روش برای پیادهسازی سریع عالی است اما یک عیب بزرگ دارد: ممکن است یک جمله مهم یا یک مفهوم کلیدی را دقیقا در وسط آن نصف کند و معنای آن را نابود سازد. برای جبران این نقص، معمولا از تکنیکی به نام «همپوشانی» (Overlap) استفاده میشود؛ یعنی به عنوان مثال هر قطعه ۲۰ درصد از انتهای قطعه قبلی را نیز در خود جای میدهد تا زمینه بحث (Context) از دست نرود.
- بخشبندی معنایی یا ساختاری (Semantic / Structural Chunking): در این روش پیشرفتهتر، سیستم به ساختار طبیعی متن توجه میکند و متن را بر اساس پاراگرافها، سرفصلهای مارکداون (H1, H2)، یا حداقل جملات کامل تقسیم میکند. این روش تضمین میکند که هر Chunk شامل یک ایده یا مفهوم کامل و یکپارچه است که کیفیت جستجوی معنایی را در مراحل بعدی به شکل چشمگیری افزایش میدهد.
- بخشبندی بازگشتی (Recursive Character Text Splitting): این روش که امروزه به عنوان استاندارد صنعتی و یکی از بهترین رویکردها شناخته میشود، سعی میکند به صورت سلسله مراتبی عمل کند. ابتدا سعی میکند متن را بر اساس پاراگرافها بشکند، اگر طول پاراگراف از حد مجاز فراتر رفت، آن را بر اساس جملات میشکند، و اگر یک جمله عجیب و غریب و طولانی وجود داشت، در نهایت آن را بر اساس کلمات تقسیم میکند. این روش بهترین تعادل را بین حفظ ساختار معنایی و رعایت محدودیت طول قطعات برقرار میسازد.
تولید تعبیه برداری (Vector Embedding)
پس از اینکه متن با موفقیت به قطعات کوچک و معنادار تقسیم شد، باید به زبان ریاضی ماشین ترجمه شود. هر قطعه متن (Chunk) به یک مدل تخصصی Embedding (مانند text-embedding-ada-002 از OpenAI، یا مدلهای متنباز و قدرتمند sentence-transformers) پاس داده میشود. وظیفه این شبکه عصبی عمیق، تبدیل قطعه متن به یک آرایه بزرگ از اعداد اعشاری است که در ریاضیات به آن بردار (Vector) میگویند. این بردارها معمولا صدها یا هزاران بُعد دارند (به عنوان مثال مدل OpenAI بردارهایی با ۱۵۳۶ بُعد تولید میکند). ویژگی شگفتانگیز و جادویی این بردارهای متراکم این است که کلمات و جملاتی که از نظر معنایی به هم شبیه هستند، در این فضای ریاضی چند بعدی، در فاصله بسیار نزدیکی از هم قرار میگیرند. برای مثال، بردار جمله «سگ پارس میکند» از نظر ریاضی به بردار جمله «گربه میو میکند» بسیار نزدیکتر است تا به بردار جمله «موتور ماشین خراب شد». این نگاشت معنا به ریاضیات، پایه و اساس سیستمهای نوین هوش مصنوعی است.
ذخیرهسازی و جستجو در پایگاه داده برداری (Vector Database)
در نهایت امر، این بردارهای طولانی اعداد به همراه متن اصلی خود و متادیتای مرتبط (مثل نام فایل اصلی، شماره صفحه و نویسنده) در یک نوع کاملا جدید و خاص از سیستمهای ذخیرهسازی به نام پایگاه داده برداری (Vector Database) ذخیره میشوند. ابزارهایی مانند ChromaDB، Pinecone، Milvus، Qdrant یا Weaviate دقیقا برای همین منظور طراحی شدهاند. پایگاههای داده سنتی SQL برای جستجوی متون یا اعداد دقیق عالی هستند، اما دیتابیسهای برداری برای انجام عملیات پیچیده جبر خطی در مقیاس عظیم بهینهسازی شدهاند.
وقتی کاربر در نهایت سوالی را در سیستم مطرح میکند، چه اتفاقی میافتد؟ سوال او نیز باید دقیقا از همین فرآیند عبور کند: سوال ابتدا به همان مدل Embedding داده شده و به یک بردار متراکم تبدیل میشود. سپس، پایگاه داده برداری وارد عمل شده و از معیارهای فاصله ریاضی برای یافتن شبیهترین بردارها استفاده میکند. سه معیار اصلی در اینجا وجود دارد:
- شباهت کسینوسی (Cosine Similarity): این معیار زاویه بین دو بردار را در فضای چند بعدی اندازه میگیرد و از اندازه بردار (طول متن) صرف نظر میکند. اگر دو بردار همجهت باشند (زاویه صفر درجه)، کسینوس آنها یک میشود که نشاندهنده شباهت معنایی کامل است. این محبوبترین روش در RAG است.
- فاصله اقلیدسی (Euclidean Distance / L2): این معیار، فاصله مستقیم و خطی بین نوک دو پیکان بردار را اندازه میگیرد.
- ضرب داخلی (Dot Product): این روش هم زاویه و هم اندازه بردار را در نظر میگیرد و محاسبه آن برای کامپیوترها بسیار سریعتر است.
با محاسبه این فواصل، مرتبطترین قطعات متن در کسری از ثانیه (حتی از میان میلیاردها سند) استخراج شده و به عنوان زمینه (Context) برای مرحله تقویت پرامپت در اختیار مدل زبانی قرار میگیرند.
چرا RAG بهترین پادزهر توهم مدلهای زبانی است؟
همانطور که پیشتر و در ابتدای مقاله اشاره کردیم، مدلهای زبانی بزرگ از اساس برای پیشبینی کلمه بعدی آموزش دیدهاند. آنها ماشینهای محاسبه آماری عظیمی هستند که بر اساس الگوهایی که در تریلیونها کلمه از اینترنت دیدهاند، محتملترین دنباله از توکنها را برای خروجی تولید میکنند. آنها هیچ مفهوم فلسفی یا درونی از «حقیقت»، «واقعیت»، «دروغ» یا «دقت علمی» ندارند. اگر از یک مدل درباره یک موضوع کاملا ناشناخته یا محرمانه بپرسید، او سعی میکند پاسخی به شدت روان، با ساختار نگارشی بینقص و لحنی حقبهجانب تولید کند که در ظاهر کاملا قانعکننده به نظر میرسد، اما ممکن است از بیخ و بن تخیلی و دروغ باشد.
روش RAG این مشکل بنیادین را با استفاده از مکانیزمی بسیار هوشمندانه به نام «لنگر انداختن به حقیقت» (Grounding) حل میکند. با تزریق اطلاعات واقعی، تاییدشده و استخراج شده از اسناد سازمانی به درون پرامپت، ما زمین بازی مدل را به شدت محدود میکنیم. ما عملا به مدل دستور میدهیم که پاسخ خود را صرفا به آن اطلاعات مشخص محدود کند. در واقع، در معماری RAG، ما از مدل زبانی به عنوان یک موتور استنتاج گر قدرتمند، درککننده زبان و خلاصهساز متن استفاده میکنیم، نه به عنوان یک پایگاه داده از حقایق حفظ شده. ما مغز استدلالی مدل را از حافظه آن جدا کردهایم.
علاوه بر این، در سیستمهای پیشرفته و سطح سازمانی RAG، معمولا به مدل صراحتا دستور داده میشود که برای هر ادعایی که مطرح میکند، به منابع خود ارجاع دقیق دهد (Citation). مثلا مدل به جای اینکه صرفا بگوید سود شرکت زیاد شده، مینویسد: «درآمد عملیاتی شرکت در سهماهه سوم سال گذشته ۲۰ درصد افزایش یافت [منبع: گزارش مالی فصلی ۲۰۲۳، پاراگراف ۴، صفحه ۱۲].» این قابلیت ارجاع به منابع، قابلیت ردیابی (Traceability)، شفافیت و در نهایت اعتماد انسانی به سیستم را به شدت افزایش میدهد که برای کاربردهای حساس تجاری، مشاورههای حقوقی و تصمیمگیریهای پزشکی امری نهتنها مفید، بلکه کاملا الزامی و حیاتی است.
بنابراین، اگر شما مدیر محصول یا توسعهدهندهای هستید که میخواهید مطمئن شوید چتبات یا دستیار هوشمند شما اطلاعات غلط، خطرناک و گمراهکننده به مشتریان ارائه نمیدهد و آبروی برند شما را با پدیده توهم به خطر نمیاندازد، مطالعه عمیق مقاله ما در مورد پدیده توهم در LLMها به شدت توصیه میشود. RAG با جدا کردن مفهوم دانش و اطلاعات (Knowledge) از منطق و مهارت استدلال (Reasoning)، راهکاری مهندسی شده، قطعی و قابل اتکا برای این چالش بزرگ عصر هوش مصنوعی ارائه داده است.
مقایسه RAG با Fine-Tuning: کِی از کدام استفاده کنیم؟
یکی از داغترین و رایجترین سوالات در میان تیمهای توسعه هوش مصنوعی این است که: برای آموزش دادههای جدید و اختصاصی سازمانمان به یک مدل زبانی، آیا باید از معماری RAG استفاده کنیم یا مدل را با دادههایمان فاینتیون (Fine-Tune) کنیم؟ برای درک بسیار عمیقتر این دوگانه مهم، حتما پیشنهاد میکنم مقاله جامع و تحلیلی ما درباره Fine-Tuning در برابر RAG در برابر Prompt Engineering را در فرصت مناسب مطالعه کنید، اما در اینجا یک مقایسه کامل و کاربردی ارائه میدهیم تا تصمیمگیری برایتان سادهتر شود.
فاینتیونینگ (Fine-Tuning) چیست؟
در فرآیند Fine-Tuning یا تنظیم ظریف، ما مستقیما در ساختار مغز مدل دست میبریم و وزنهای عصبی (Neural Weights) خود مدل پایه را تغییر میدهیم. برای این کار، ما هزاران یا دهها هزار مثال دقیق از نوع خاصی از وظایف (Task) را در فرمت پرسش و پاسخ آماده میکنیم و مدل را با صرف هزینه پردازشی زیاد، مجددا آموزش میدهیم. اگر به استعاره کتابخانهدار برگردیم، این کار مانند فرستادن کتابخانهدار به دانشگاه برای گذراندن یک دوره تخصصی چند ماهه است. او پس از بازگشت، لحن خاص، سبک نگارش مختص سازمان شما و نحوه برخورد با مسائل روانشناختی مشتریان را در وجود خود نهادینه کرده است.
تفاوتهای کلیدی و کاربردهای هر روش
۱. دانش پویا در برابر دانش ایستا: اگر دادههای شما پویا هستند و مدام تغییر میکنند (مثل اخبار روزانه، قیمت لحظهای سهام، موجودی انبار فروشگاه، یا قوانین جدید سازمان)، RAG تنها گزینه منطقی، ارزان و عملی است. شما قطعا نمیتوانید برای هر تغییر کوچکی که در قیمت یک محصول رخ میدهد، یک مدل ۱۰۰ میلیارد پارامتری را از نو Fine-Tune کنید؛ این کار از نظر مالی و زمانی غیرممکن است. با RAG، شما فقط دیتابیس برداری خود را با یک کلیک آپدیت میکنید و مدل بلافاصله به اطلاعات جدید دسترسی پیدا میکند. اما فاینتیونینگ برای یادگیری دانش ایستا که در طول زمان تغییر نمیکند (مثلا یادگیری یک زبان برنامهنویسی جدید، آموزش تشخیص لهجه خاص، یا یک سبک خاص از نگارش ادبی شبیه به شکسپیر) بسیار مناسبتر است.
۲. هزینه، زیرساخت و پیچیدگی اجرا: پروژه Fine-Tuning نیازمند تیم متخصص داده برای ایجاد دیتاستهای آموزشی تمیز و ساختاریافته، سختافزار بسیار قدرتمند (کلاسترهای شامل GPUهای گرانقیمت مانند H100) و زمان پردازش طولانی است. در مقابل، راهاندازی یک سیستم اولیه RAG به لطف کتابخانههایی مانند LangChain و LlamaIndex بسیار ارزانتر، سریعتر و کمدردسرتر است و هیچ نیازی به دستکاری و تغییر مدل پایه (Base Model) ندارد. شما میتوانید با استفاده از APIهای موجود با کمترین هزینه یک RAG پیاده کنید.
۳. امنیت دادهها و حفظ حریم خصوصی: در یک معماری RAG خوشساخت، تمام دادههای حساس و محرمانه شما درون پایگاه داده خصوصی خودتان در شبکه داخلی (On-Premise) باقی میمانند و فقط در لحظه پرسش کاربر، بخشهای کوچکی از متن که مرتبط هستند به عنوان پرامپت به مدل ارسال میشوند (که آن هم میتواند با رمزنگاری یا استفاده از مدلهای متنباز محلی ایمن شود). در Fine-Tuning با مدلهای ابری، شما مجبورید تمام دادههای حساس شرکت را در قالب دیتاست به سرورهای شرکت ارائهدهنده مدل (مثل OpenAI) ارسال کنید تا مدل روی آنها آموزش ببیند، که این امر ریسک امنیتی بسیار بالایی برای سازمانهای محافظهکار دارد.
۴. توانایی جلوگیری از توهم: همانطور که به تفصیل بحث شد، RAG در مهار کردن و جلوگیری از توهم بسیار موفقتر و قابلاعتمادتر از Fine-Tuning است. فاینتیونینگ به مدل حقایق جدیدی را در لابلای وزنهایش یاد میدهد، اما به هیچ وجه تضمین نمیکند که مدل هنگام پاسخگویی، آن حقایق را با اطلاعات قدیمی و متناقض قبلی خود قاطی نکند یا دچار فراموشی فاجعهبار (Catastrophic Forgetting) نشود.
در نهایت، رویکرد مدرن و بلوغیافته در صنعت هوش مصنوعی، استفاده ترکیبی و هوشمندانه از هر دو تکینک است: تیمهای پیشرو از Fine-Tuning برای تنظیم لحن سازمانی، فرمت پاسخدهی استاندارد و آموزش نحوه رفتار کلی مدل استفاده میکنند، و به صورت همزمان از سیستم RAG برای تزریق دانش تخصصی، فکتها و اطلاعات لحظهای و بهروز بهره میبرند.
یک خط لوله RAG ساده با پایتون و ChromaDB
برای اینکه از دنیای مفاهیم تئوری فاصله بگیریم و این معماری را به صورت عملی و ملموس مشاهده کنیم، در اینجا یک نمونه کد پایتون نسبتا کامل با استفاده از کتابخانههای فوقالعاده محبوب LangChain و ChromaDB برای ساخت یک خط لوله RAG کاملا عملیاتی آورده شده است. این کد به وضوح نشان میدهد که چقدر پیادهسازی و ساخت پروتوتایپ از این سیستمهای پیچیده در دنیای واقعی، به لطف ابزارهای مدرن برنامهنویسی، ساده و در دسترس شده است. شما میتوانید با استفاده از این کد یک دستیار هوشمند سازمانی بسازید.
import os
from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma
from langchain_openai import ChatOpenAI
from langchain.chains import create_retrieval_chain
from langchain.chains.combine_documents import create_stuff_documents_chain
from langchain_core.prompts import ChatPromptTemplate
# مرحله صفر: تنظیم کلید API برای دسترسی به سرویسهای ابری
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY_HERE"
# مرحله ۱: بارگذاری سند (Data Loading & Ingestion)
# در اینجا یک فایل متنی ساده حاوی قوانین داخلی شرکت را بارگذاری میکنیم
print("در حال بارگذاری اسناد...")
loader = TextLoader('company_policy_document.txt', encoding='utf-8')
documents = loader.load()
# مرحله ۲: بخشبندی سند متنی (Chunking & Splitting)
# ما از RecursiveCharacterTextSplitter استفاده میکنیم تا حد امکان به ساختار پاراگرافها و جملات احترام بگذاریم
print("در حال بخشبندی متن...")
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=600, # اندازه هر قطعه را به ۶۰۰ کاراکتر محدود میکنیم
chunk_overlap=100 # ۱۰۰ کاراکتر همپوشانی برای حفظ پیوستگی معنایی بین قطعات
)
chunks = text_splitter.split_documents(documents)
print(f"سند به {len(chunks)} قطعه مجزا تقسیم شد.")
# مرحله ۳: تولید بردارهای ریاضی و ذخیره در دیتابیس برداری (Embedding & VectorStore Initialization)
# از مدل استاندارد و قدرتمند text-embedding-ada-002 شرکت OpenAI برای تولید Embedding استفاده میکنیم
print("در حال تولید بردارها و ساخت پایگاه داده...")
embeddings = OpenAIEmbeddings(model="text-embedding-ada-002")
# ذخیره تمامی قطعات متنی و بردارهای متناظر آنها در یک دیتابیس Chroma که روی دیسک محلی ذخیره میشود
vectorstore = Chroma.from_documents(
documents=chunks,
embedding=embeddings,
persist_directory="./chroma_db_storage"
)
# ایجاد یک آبجکت Retriever از دیتابیس برداری برای انجام عملیات جستجو
# ما به دیتابیس میگوییم جستجو را بر اساس شباهت کسینوسی (Similarity) انجام دهد و ۴ قطعه مرتبط برتر (k=4) را برگرداند
retriever = vectorstore.as_retriever(search_type="similarity", search_kwargs={"k": 4})
# مرحله ۴: آمادهسازی مدل زبانی بزرگ و قالب پرامپت (LLM & Prompt Engineering)
# از مدل هوشمند GPT-4 با درجه حرارت صفر (temperature=0) برای جلوگیری از خلاقیت بیمورد و تمرکز روی فکتها استفاده میکنیم
llm = ChatOpenAI(model_name="gpt-4-turbo", temperature=0)
# تعریف یک سیستم پرامپت سختگیرانه برای کنترل رفتار مدل
system_prompt = (
"شما یک دستیار هوشمند و بسیار دقیق برای کارمندان این شرکت هستید. "
"لطفا برای پاسخ به سوال کاربر، صرفا و فقط از اطلاعات بازیابی شده زیر استفاده کنید. "
"اگر پاسخ سوال را در میان این اطلاعات پیدا نکردید، حق حدس زدن ندارید و باید مستقیما بگویید "
"که بر اساس اسناد موجود فعلی، اطلاعاتی در این زمینه ندارید. "
"پاسخهای خود را با لحنی حرفهای، ساختاریافته، در قالب ۳ تا ۵ جمله و به صورت کاملا خلاصه بیان کنید.\\n\\n"
"--- اطلاعات استخراج شده از پایگاه دانش ---\\n"
"{context}\\n"
"------------------------------------------"
)
# ترکیب سیستم پرامپت و ورودی کاربر
prompt = ChatPromptTemplate.from_messages([
("system", system_prompt),
("human", "{input}"),
])
# ساخت یک زنجیره برای قرار دادن اسناد یافت شده در متغیر {context} در پرامپت (Augmentation)
document_chain = create_stuff_documents_chain(llm, prompt)
# مرحله ۵: ایجاد زنجیره کامل و نهایی RAG (ترکیب Retrieval و Generation)
rag_chain = create_retrieval_chain(retriever, document_chain)
# مرحله ۶: تعامل با کاربر و اجرای سیستم
user_question = "مقررات شرکت در مورد استفاده از لپتاپهای شخصی برای پروژههای دورکاری چیست؟"
print(f"\\nسوال کاربر: {user_question}")
print("سیستم در حال جستجو و تفکر...")
# فراخوانی زنجیره با ارسال سوال کاربر
# در این مرحله، سوال وکتور میشود، جستجو انجام میپذیرد، پرامپت ساخته میشود و مدل پاسخ میدهد
response = rag_chain.invoke({"input": user_question})
print("\\n--- پاسخ نهایی مدل زبانی ---")
print(response["answer"])
در این قطعه کد جامع و خوانا، ما عملا تمام چرخه حیات یک سیستم پیشرفته را پیادهسازی کردیم: سند خام سازمانی را گرفتیم، با دقت آن را به قطعات کوچک خرد کردیم، قطعات را توسط شبکههای عصبی به اعداد و بردارهای ریاضی تبدیل کردیم، در یک دیتابیس برداری بهینه ذخیره نمودیم، در زمان پرسش نزدیکترین مفاهیم ریاضی را استخراج کردیم و در نهایت به یک مدل زبانی بزرگ دستور دادیم تا با محدودیت شدید و بر اساس آن مستندات، پاسخی کاملا دقیق و بدون توهم تولید کند. این دقیقا همان جادوی قدرتمندی است که در پشت پرده ابزارهایی که امروزه به نام Chat with PDF، دستیاران برنامهنویسی مبتنی بر کدبیس شرکت، و رباتهای پشتیبان هوشمند میشناسیم، در حال اجراست.
کلام پایانی: حافظه، ستون فقرات هوش
اگر سیستمهای هوش مصنوعی را به عنوان یک مغز سیلیکونی در نظر بگیریم، معماری RAG دقیقا معادل هیپوکامپ (بخش مسئول شکلگیری و دسترسی به حافظه بلندمدت) در مغز انسان عمل میکند. مدلهای زبانی به تنهایی فقط مکانیزمهای پردازشی خام و موتورهای استدلالی هستند که منطق، قواعد گرامری و الگوهای زبانی را به شکل شگفتانگیزی درک میکنند، اما بدون دسترسی سریع به اطلاعات دقیق، پویا و شخصیسازی شده سازمانی، کارایی آنها در حل مسائل دنیای واقعی به شدت محدود، غیرقابل اعتماد و حتی خطرناک است. اضافه کردن یک حافظه برونسازمانی و قابل اعتماد از طریق معماری انعطافپذیر «تولید تقویتشده با بازیابی» (RAG)، این پردازشگرهای متنی کور را به دستیاران دانشمند، محتاط و تحلیلگرانی تبدیل میکند که نهتنها خیلی خوب و روان حرف میزنند، بلکه حرفهای بسیار خوب، دقیق، ارزشمند و مستندی برای گفتن دارند.
در آیندهای نهچندان دور، با پیشرفت خیرهکننده تکنیکهای پیچیدهتر و ترکیبی مانند Graph RAG (استفاده از گرافهای دانشی عظیم برای درک ارتباطات شبکهای پیچیده میان هزاران سند مجزا) و Agentic RAG (سیستمهای مبتنی بر عامل، جایی که مدل هوشمند خودش تصمیم میگیرد چه زمانی جستجو کند، از چه ابزار خارجی یا API استفاده کند، کوئری جستجو را چگونه اصلاح کند و چه زمانی پاسخ نهایی را تولید کند)، سیستمهای بازیابی اطلاعات بسیار هوشمندتر، خودمختارتر و دقیقتر خواهند شد. با این وجود، درک کامل و عمیق اصول اولیه معماری RAG، تسلط بر مفاهیم پایهای چون استراتژیهای چانکینگ، کار با پایگاههای داده برداری، نحوه محاسبه شباهت معنایی، و هنر نوشتن پرامپتهای تقویتشده محدودکننده، اولین، ضروریترین و مهمترین گام برای ورود مقتدرانه به عصر طلایی مهندسی سیستمهای هوش مصنوعی سازمانی به شمار میرود.
این فناوری بینظیر، مرزهای امکان استفاده از هوش مصنوعی مولد را در محیطهای تجاری و صنعتی جابجا کرده است و به توسعهدهندگان و شرکتها اجازه میدهد تا با صرف هزینه و زمان اندک، سیستمهایی بسیار پاسخگو، مقیاسپذیر و ایمن بسازند. شما چه در حال طراحی و ساخت یک چتبات پاسخگو برای پشتیبانی شبانهروزی مشتریان خود باشید، چه در حال توسعه یک ابزار پیشرفته برای تحلیل دهها هزار صفحه اسناد حقوقی و قراردادهای پیچیده، و چه یک موتور جستجوگر هوشمند سازمانی برای یافتن سریع دانش پنهان در شرکت، RAG قطبنمای اصلی شما برای فرار از طوفان سهمگین توهمات مدلهای زبانی و رسیدن به ساحل امن اعتماد و دقت خواهد بود. علاوه بر این، درک عمیق این تکنیکها میتواند در بهینهسازی فرآیندهای کسبوکار نقش بسزایی داشته باشد و هزینههای عملیاتی را به شدت کاهش دهد. برای درک بهتر مفاهیم پایهای مدلها، پیشنهاد میکنیم مروری بر مطلب پارامتر، توکن و پنجره زمینه داشته باشید تا تصویر شما از این اکوسیستم کاملتر شود.